
摩尔线程深度接入 HUATUO 开源生态,实现 GPU 全栈可观测
近日,摩尔线程全功能 GPU 可观测能力正式合入 HUATUO(华佗)开源社区官方主线。通过摩尔线程贡献的 PR #641,运维人员与开发者无需配置私有补丁,即可在 HUATUO 中获取 GPU 运行状态,并在同一时间线上关联设备侧与主机侧数据,开展单机与集群的监控和故障排查。
此次接入将 GPU 设备状态、PCIe 链路与 MTLink 跨卡互联纳入统一的观测入口,为智算集群日常巡检、异常定位和容量规划提供数据基础。
支持概览
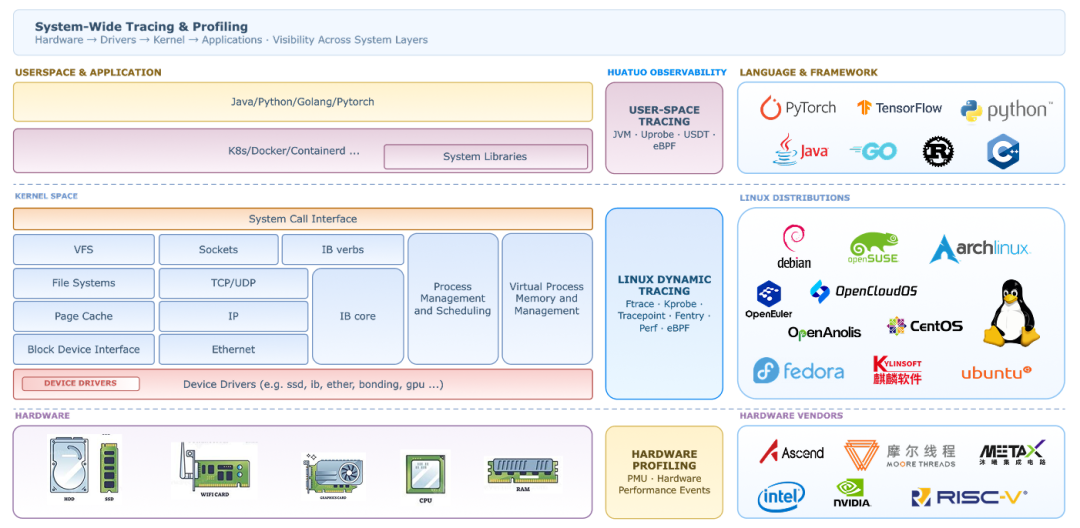
HUATUO 是由滴滴开源、中国计算机学会(CCF)孵化的操作系统级深度观测项目,面向云原生通用计算、AI 计算及裸金属基础服务,利用 eBPF 与内核动态追踪技术提供深度观测能力。
随着国产 AI 算力进入规模化部署阶段,显存压力、芯片过热、PCIe 降级和跨卡链路异常成为训练与推理排障中需要关注的问题。仅依赖主机侧日志、调度和网络信号,往往难以直接确认设备状态;逐一调用厂商 CLI、解析输出,也增加了多卡与集群环境中的运维成本。
摩尔线程 GPU 的接入,使设备侧信号能够与 HUATUO 已有的主机侧观测数据结合,帮助运维人员缩小异常范围。
业务价值
该能力统一采集 GPU、PCIe 与 MTLink 指标,关联主机侧数据,支持日常监控与故障排查,并通过长期趋势分析辅助容量规划和健康巡检。典型故障的排查方向如下:
| 典型现象 | 可关联信号 | 可能的排查方向 |
|---|---|---|
| 未修改代码、batch 或学习率,单卡训练吞吐突然下降 | 核心温度、当前与最大频率、风扇转速、当前功耗与功率上限 | 芯片过热降频、风扇异常、功率限制 |
| 显存看似充足,但任务间歇性 OOM 或显存分配失败 | 显存温度、已用量与总量、当前与最大显存频率 | 显存温度或频率异常,并结合显存使用情况排查 |
| 多卡集合通信(如 all-reduce)变慢 | PCIe 当前与最大速率、当前与最大宽度、重传计数、MTLink 状态 | PCIe 协商降级、链路质量问题、MTLink 异常 |
新增观测能力
原生采集与统一输出
mthreads_gpu 采集器调用摩尔线程官方 MTML 库读取 GPU 运行状态,将数据转换为标准 Prometheus 指标,通过 HUATUO 原生 /metrics 端点统一暴露,无需额外部署 sidecar。
采集器将随时间变化的动态指标纳入高频轮询,并在多卡场景下并行采集;驱动或底层库出现偶发异常时,按规则尝试自动重连。
首批接入的观测范围如下:
| 指标类别 | 观测范围 | 关键数据 |
|---|---|---|
| 基本信息 | 设备识别与资产信息 | 型号、序列号、PCI / BIOS 信息、显存规格 |
| 运行状态 | 健康、负载与显存 | 芯片及显存温度、功耗、电压、功率上限、计算与显存利用率、显存总量与已用量 |
| 运行状态 | 频率、散热与性能状态 | GPU / 显存当前与最大频率、风扇转速及百分比、P-state |
| 运行状态 | VPU | 总利用率、编解码利用率、时钟频率 |
| PCIe | 主机与设备间链路 | 当前与最大速率(GT/s)、当前与最大宽度(lane)、重传计数 |
| MTLink | 机内跨卡互联 | 每条链路状态、单链路带宽、链路数 |
常用指标
/metrics 中的指标系列以 mthreads_gpu_ 为前缀。下表沿用原文中的指标名称,省略此前缀:
| 指标名称 | 含义与排查用途 |
|---|---|
gpu_temperature_celsius |
GPU 核心温度,可结合频率和吞吐变化检查散热及限频问题 |
gpu_utilization_percent、memory_utilization_percent |
GPU 计算与显存利用率,用于分析负载特征及数据供给情况 |
memory_used_bytes、memory_total_bytes |
显存已用量与总量,用于观察显存压力 |
memory_temperature_celsius |
显存温度,可与容量、频率等信号结合排查异常 |
pcie_link_speed_gt_per_sec、pcie_link_max_speed_gt_per_sec |
PCIe 当前协商速率与最大速率,用于检查链路是否存在降级 |
pcie_replay_total |
PCIe 重传计数,持续增长时需关注链路质量 |
mtlink_state |
MTLink 链路状态,按 link 标签区分;0、1、2 分别表示 DOWN、UP、DOWNGRADE |
fan_rpm、fan_speed_percent |
风扇转速与百分比,按 fan 标签区分,可结合 GPU 温度检查散热状态 |
所有指标均携带 gpu=<index> 标签,多卡场景下可按设备筛选与聚合。上述信号用于提供排查方向,具体原因需结合任务负载和其他观测数据确认。
配置与部署
使用包含该采集器的 HUATUO 版本,并安装摩尔线程 GPU 驱动及 MTML 动态库。从全局 BlackList 中移除 "mthreads_gpu" 后,按需开启健康、PCIe 和 MTLink 指标:
|
|
裸机可直接运行;Docker / Kubernetes 部署需映射设备节点(/dev/dri/renderD*、/dev/mtgpu.*),并挂载 libmtml.so。启动 HUATUO 后,即可在 /metrics 端点查看以 mthreads_gpu_ 为前缀的指标。
后续规划
指标接入是摩尔线程与 HUATUO 合作的第一步。原文提出,后续将围绕以下方向继续完善观测能力:
- 异常事件实时上报:将温度阈值触发、风扇停转、PCIe 降速、MTLink 状态切换等异常转换为结构化事件,缩短告警响应时间。
- 线上持续性能分析:打通底层 profiling 工具链,在不重启生产服务的前提下进行轻量级性能定位,并按需启动深度采样。
- 集群网络拓扑观测:接入 MTLink 机内互联与 RDMA 跨机网络的拓扑和性能数据,观察卡间及跨节点通信。
- AI 作业端到端追踪:关联设备侧指标、PyTorch 等上层 AI 框架与主机侧调度上下文,扩展训练和推理作业的全链路追踪能力。
结语
后续双方将继续通过开源协作,推进从指标监测到异常事件、性能分析与端到端追踪的能力建设,帮助开发者和运维团队管理规模化 AI 基础设施。
相关链接
- 微信原文(摩尔线程开发者):摩尔线程深度接入 HUATUO 开源生态,实现 GPU 全栈可观测
- HUATUO GitHub:https://github.com/ccfos/huatuo