
irqtracing,一次定位中断突刺问题的探索
背景
线上环境中,我们经常会遇到一类较为棘手的问题:同一台宿主机上的多个容器突然同时出现服务耗时突刺。回溯历史监控数据后发现,问题发生时段该机器集中处理了大量中断,众多 CPU 核心的 cpu.irq 和 cpu.softirq 使用率骤然攀升。然而,历史监控虽能定位到异常的 CPU 核心,却难以还原当时的完整现场。
这类问题通常以偶发形式出现,持续时间往往仅有数十秒甚至更短。由于仅部分 CPU 核心出现中断突增,机器整体负载和单个容器的负载变化并不明显,不足以触发常规的现场抓取工具进行自动采集。
针对这一场景,我们开发了一款 CLI 工具 – irqtracing,期望能够为此类问题的根因分析提供有效的辅助手段。
解决方案
如何解决这一问题?我们可以将其拆解为以下几个关键环节:
-
及时发现系统异常 – 在问题发生的第一时间感知到中断突增等异常信号。
-
采集异常现场,定位问题根源 – 在异常窗口内快速捕获完整的现场信息,为根因分析提供数据支撑。
-
以直观的方式呈现线索 – 将采集到的原始数据转化为易于解读的结果,辅助开发者快速锁定问题方向。
问题检测
在异常检测方面,我们采用了较为直接的思路:以固定的时间间隔采样各 CPU 的中断使用情况,并基于自定义的评价逻辑,判断 CPU 是否发生了中断突增。
首先,计算每个 CPU 在相邻采样窗口中用于硬中断和软中断的时间占比:
|
|
然后,我们结合线上实际场景的观察,制定了以下两条判定规则(规则阈值均可根据实际使用情况进行动态调整):
-
多核并发突增:若多个 CPU 同时检测到中断使用率突增,则判定系统当前出现异常场景。
-
单核持续高位:若某一特定 CPU 在连续多个采集周期内均维持高资源消耗状态,则判定该 CPU 存在异常。
默认阈值如下:
| 异常模式 | 判断方式 | 采集目标 |
|---|---|---|
| 多 CPU 突增 | 至少 3 个 CPU 同时增加 20 个百分点,且相对上一窗口增长至少 30% | 增幅最大的 CPU |
| 单 CPU 持续高 | 一个 CPU 连续 10 个窗口达到 80% | 发生异常的 CPU |
通过上述方法确认目标 CPU 后,HuaTuo 会自动触发该 CPU 上的现场采集,并回收核心信息。
现场采集
熟悉 HuaTuo 的朋友可能了解,我们此前已开发了若干针对中断问题的诊断功能。例如,通过检测 sched tick 是否正常触发,可以判断中断是否被长时间关闭及具体原因。然而,该机制在当前场景下并不适用 – 此处我们面临的并非长时间关闭中断,而是短时间内海量中断的频繁触发:单次中断的执行时间极短,但其高频率持续打断系统正常运行,从而对系统性能产生影响。
这些中断产生的原因是什么?它们都影响到了谁?它们到底在忙什么?irqtracing试图回答这些问题。
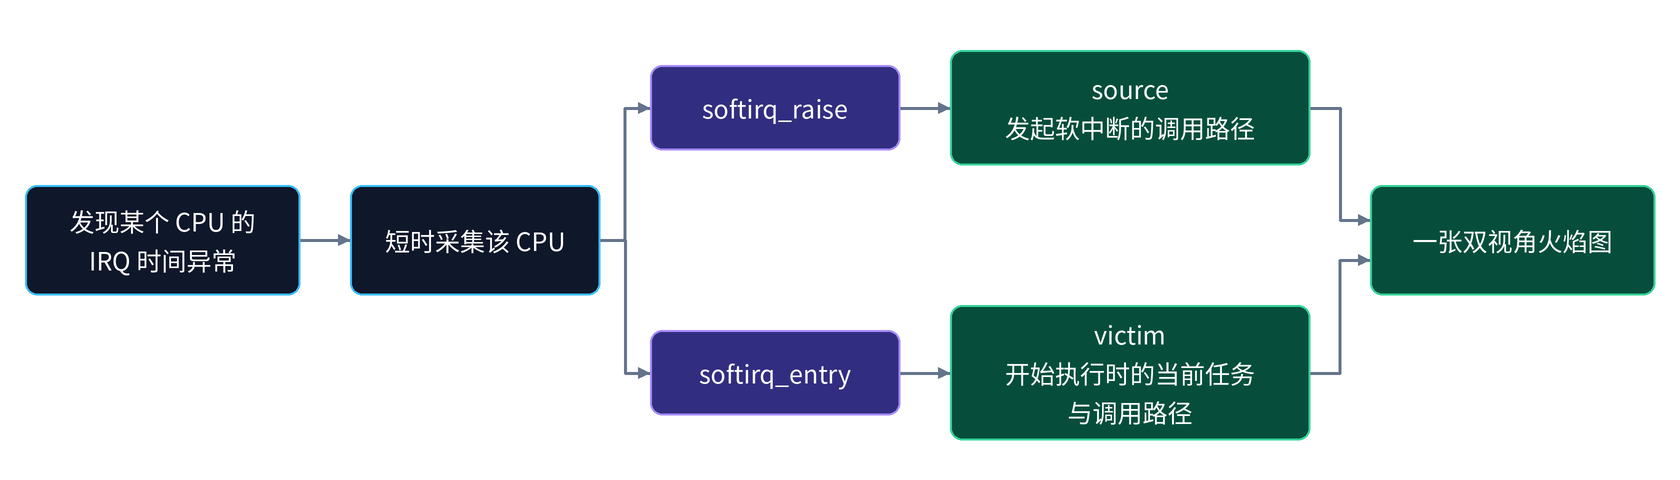
我们的解法关键依托于两个 tracepoint:irq:softirq_raise 与 irq:softirq_entry。
-
irq:softirq_raise 的作用是收集指定 CPU 上所有触发过软中断的调用栈信息,即梳理这些软中断的”触发来源“。其触发路径可能包括:中断快速处理完成后触发软中断,以及某些场景下在内核代码中直接触发软中断。
-
irq:softirq_entry 的作用是收集指定 CPU 上所有被软中断打断的程序,即标识这些中断的”受害者“。受影响的程序可能包括:内核线程、进入内核态执行的用户进程,以及运行于用户态的用户进程。
以下是softirq_raise和softirq_entry的调用栈例子:
softirq_raise:
|
|
softirq_entry:
|
|
基于这两个栈提供的调用链,我们可以大致推测出他们发生的场景:
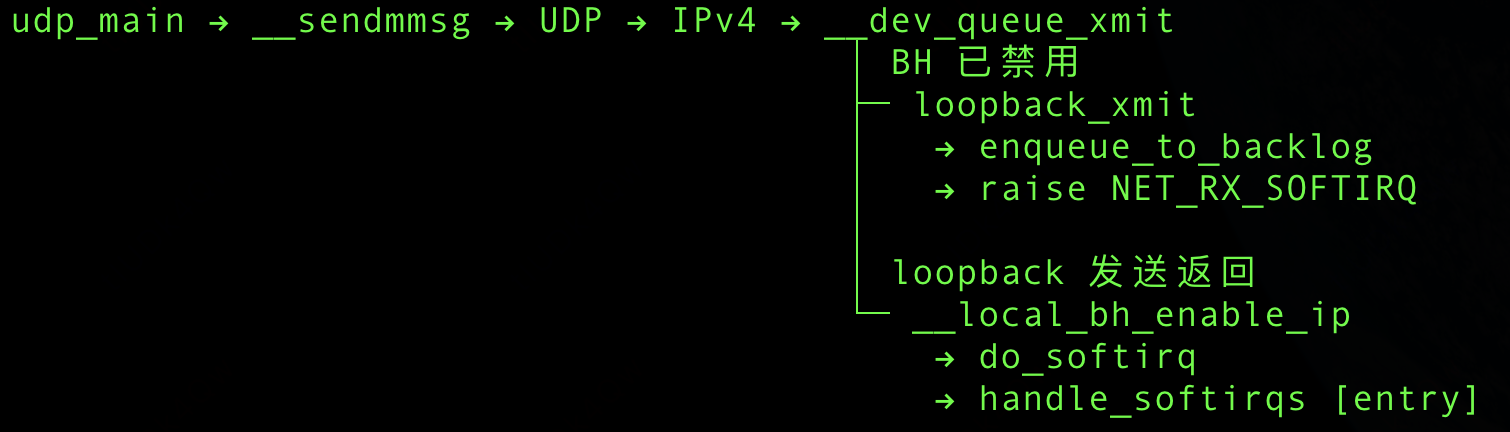
同一任务在 sendmmsg() 内触发接收软中断,并在恢复 BH 后就地执行软中断。两次采样时,任务都处于 pid 1663386 的同一次发送调用中。
按时间顺序看:
-
raise 是工作来源:pid 1663386 任务发送 UDP 报文,loopback 将报文放入接收 backlog,并置位当前 CPU 的 NET_RX_SOFTIRQ pending。
-
entry 是执行入口:同一发送路径恢复 BH 时发现 pending,直接开始处理软中断。因此 CPU、PID 和用户栈都相同;系统调用此时尚未返回。
-
相同用户栈表示相同的调用背景:两次都停留在 udp_main → __sendmmsg。entry 时当前任务仍是发送任务,执行上下文已经是中断上下文。
值的注意的是,上述调用栈并不代表 UDP 接收端一定是 pid 1663386,它只是恰逢其会执行了entry而已。
借助这两个 tracepoint,我们能够还原出大部分中断负载发生时的工作状况,并准确追溯其来源(source)与受害者(victim)。
然而,针对我们要解决的场景,还存在一个显而易见的问题 – 调用栈固然能够清晰描述单次中断的细节,但我们将面对的是短时间内集中爆发的中断潮。诚然,此期间的某一次栈信息可能颇具代表性,甚至能为问题的根因指明方向,但我们不能仅凭一个或几个采样便武断地概括所有可能发生的事件。那么,增加采样数量是否可行?有过线上问题排查经验的同学立刻就会联想到终端窗口中被无数调用栈刷屏的场景 – 即便借助 AI 辅助,想要从中筛选出明确的线索,依然是一件颇费功夫的差事。
如何才能既充分采集信息、避免采样引入误判,又直观地呈现线索?我们的方案是 – 火焰图。具体而言,在极短的时间窗口内尽可能采集所有发生的中断事件,随后按照 source 与 victim 两个维度对调用栈进行聚合,最终生成一份双视角火焰图。
这里展示一个效果图例子:
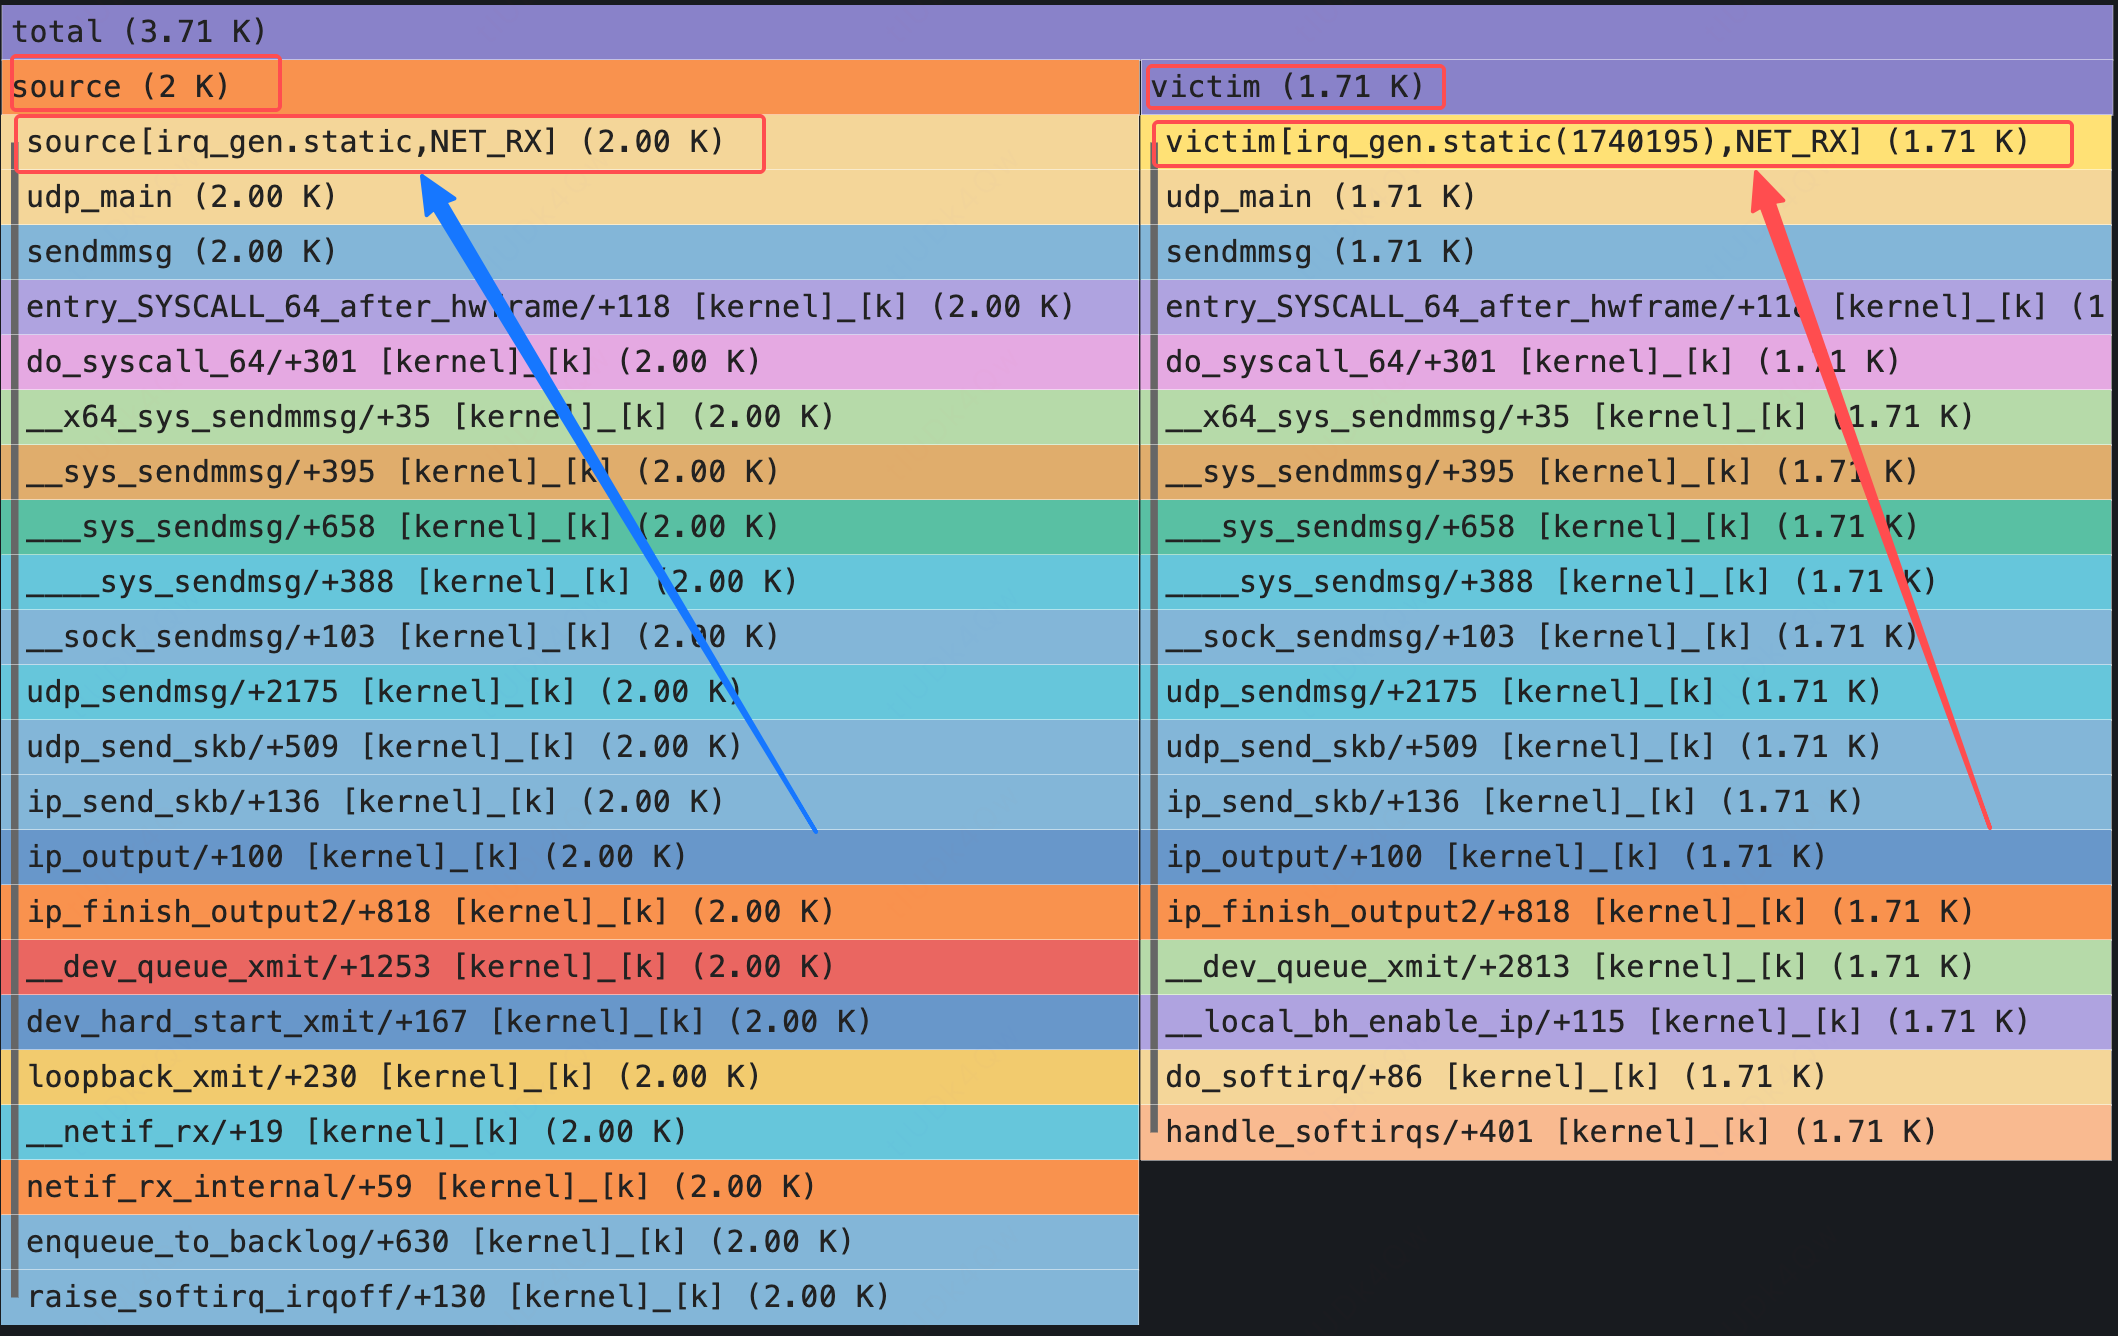
在上图例子中:
-
整体聚合后共采集到3709次调用栈;
-
source 侧可以确认多达2000次完全相同的调用栈触发 NET_RX 软中断;
-
victime 侧同一个进程(PID 1740795)被 NET_RX irqentry 打断 1706;
-
该进程运行期间还发生过两次 RCU 类型的中断,只因采样宽度过小,被 NET_RX 的庞大数据量所淹没。
这样一张图,可以非常直观的满足我们定位问题中的大部分需求:
第一,它把大量零散的调用栈变成了热点分布。同一条调用路径反复出现,会在图上形成更宽的区域。排查者可以先看主要集中在哪种软中断,再向下展开具体调用链,而不必逐条翻栈记录。
第二,source 和 victim 在同一份结果中各有一个根节点。source 一侧主要指向某类中断,例如 NET_RX 相关路径,victim 一侧频繁出现某个业务进程,就能形成一个清晰的排查方向:网络软中断活动是否正在与该业务争用 CPU。两侧还保留了软中断类型和任务标签,方便从“哪一类事件”继续缩小到“哪些调用路径、哪些任务”。
第三,它让“发起者”和“现场任务”各自保持清楚的含义。如传统火焰图般把所有栈混在一棵树里,容易只看到最宽的函数;分成两侧后,读图时可以发现:哪里在频繁发起软中断?软中断执行时,哪些任务经常在 CPU 上?
需要说明的是:这是一张用于定位线索的聚合图。不能具体确定某一条 source 恰好打断了另一条 victim,图上的宽度表示事件出现次数,不能直接解读成耗时。
工具试用
结合上述探测与采集功能,irqtracing 在 HuaTuo 中的工作模式如下:
-
按照既定规则发现异常,并选定目标 CPU 进行采集;
-
触发 irqtracing CLI 采集中断现场;
-
自动追踪模式下,irqtracing CLI 的采集结果由 HuaTuo 自动保存;
-
irqtracing CLI 也可按需独立运行,直接得到火焰图。
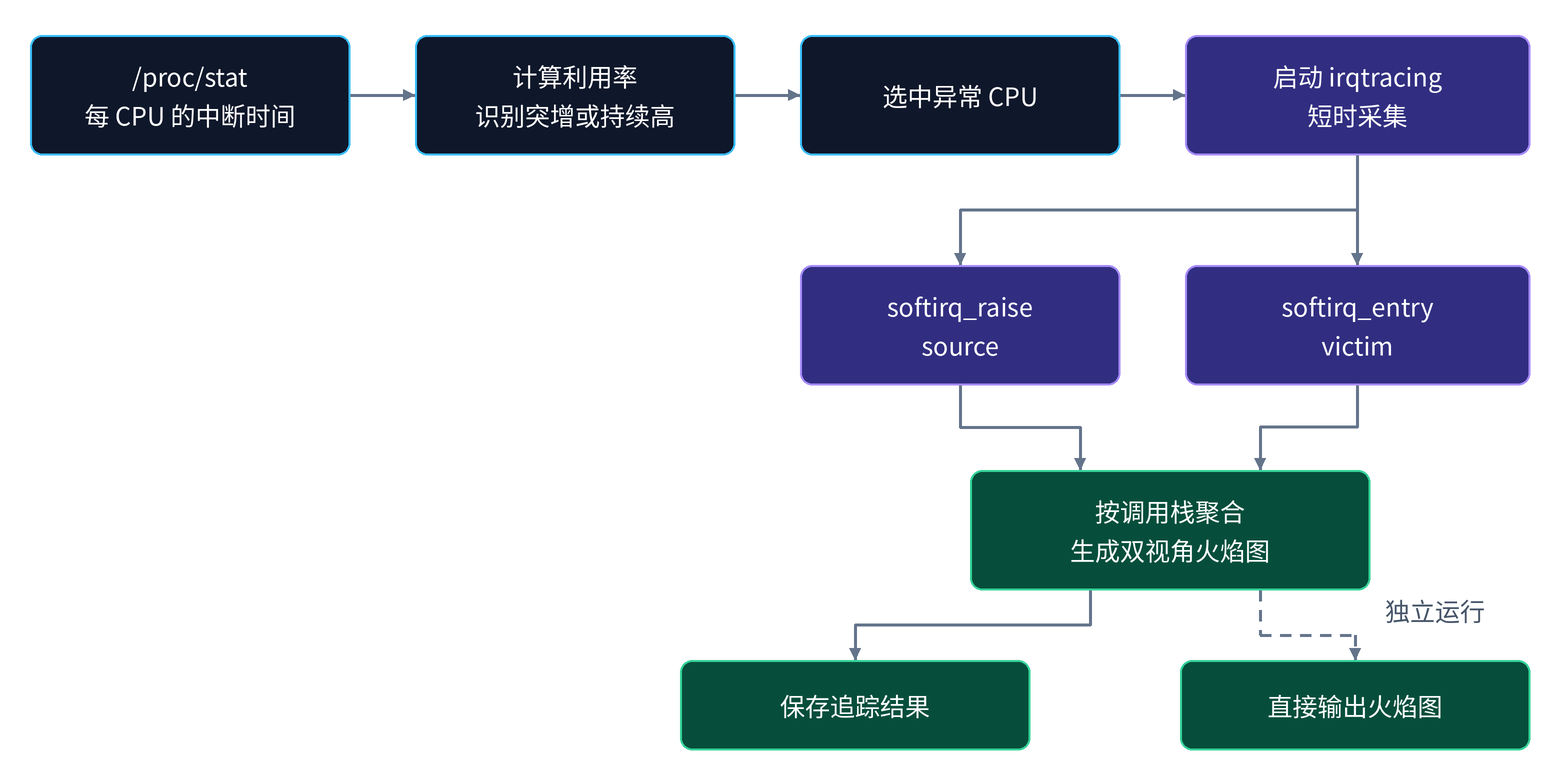
手动运行的方式也非常简单,项目构建后,可以单独采集指定 CPU,并直接输出 SVG 火焰图:
|
|
当前的解决方案仍存在一些不足之处。例如,判断 IRQ 利用率是否构成一次突刺的标准,目前仍依赖经验设计,并非最合理、最精确的判定方式。若能创新性地设计更科学的算法,将对采集准确性及类似指标(如 cpuidle、cpusys)的判定优化产生显著价值。此外,软中断亦可能在线程上下文中执行,其对系统其他任务的影响主要体现在调度延迟方面。考虑到处理此类情况将大幅增加工具的复杂度,且带来的收益有限,我们暂未将其纳入本工具的覆盖范围。
尽管如此,irqtracing 工具的开发仍是我们在分析此类问题上的一次探索,期望能够为定位相关线上故障提供帮助,欢迎大家试用并提出优化建议。