
基于 Go 运行时采样统计的进程外堆内存快照方法
摘要
应用未暴露堆 profile 导出接口时,进程级内存指标难以提供按分配调用栈组织的归因信息。本文分析 Go 运行时堆采样的概率模型、bucket 数据组织及跨 GC 周期发布机制,并说明 Huatuo 如何从进程外定位统计入口、读取已发布的 active 计数与调用栈、执行概率校正并生成在用内存热点快照。该方法复用运行时已有采样统计,在目标采样已启用、已有发布统计、版本可识别且读取权限满足时,无需应用提供 HTTP 导出接口。
关键词: Go;堆内存采样;pprof;进程外采集;概率校正;Huatuo
1. 引言
进程 RSS 或容器内存用量能够反映内存压力,但仅凭这些总量无法确定相关的 Go 分配调用栈。Go heap profile 提供按分配位置聚合的统计,但常规获取方式依赖应用导出 HTTP 接口或调用文件导出函数。当这些入口不可用时,已有运行时采样统计仍可能存在,进程外读取因此成为一种可选的诊断方式。
本文研究的问题是:在不调用目标进程 profile 导出函数的条件下,如何获取按分配调用栈组织的堆内存统计,并准确界定其统计含义与适用条件。本文将“堆内存快照”定义为一次采集窗口内读取并聚合的运行时采样统计,不包含逐对象地址、类型字段或引用图,也不预设读取过程具有原子性。
本文围绕 Huatuo Go provider 展开方法分析。分析范围包括 Go 1.18–1.26 所列版本标签的相关 64 位布局,以及 Huatuo 的变量定位、批量读取、在用估算和符号化路径。研究内容包括:建立采样对象、周期计数与输出指标之间的对应关系;说明进程外采集方法及版本适配要求;分析采样、发布时点和并发读取对结果的影响。本文采用源码分析与模型推导。
2. 背景与相关工作
2.1 pprof 的统计表示
Go heap profile 按分配调用栈聚合对象数量和字节数,分别支持累计分配与在用内存分析。对于已暴露 pprof HTTP 接口的应用,可通过以下命令获取 profile,并查看在用字节数与对象数:
|
|
除 HTTP 接口 外,应用也可调用 runtime/pprof.WriteHeapProfile 将堆 profile 写入文件。两种导出方式使用同一类运行时统计。
以下 -inuse_space 输出用于说明字段含义,数值为示例:
|
|
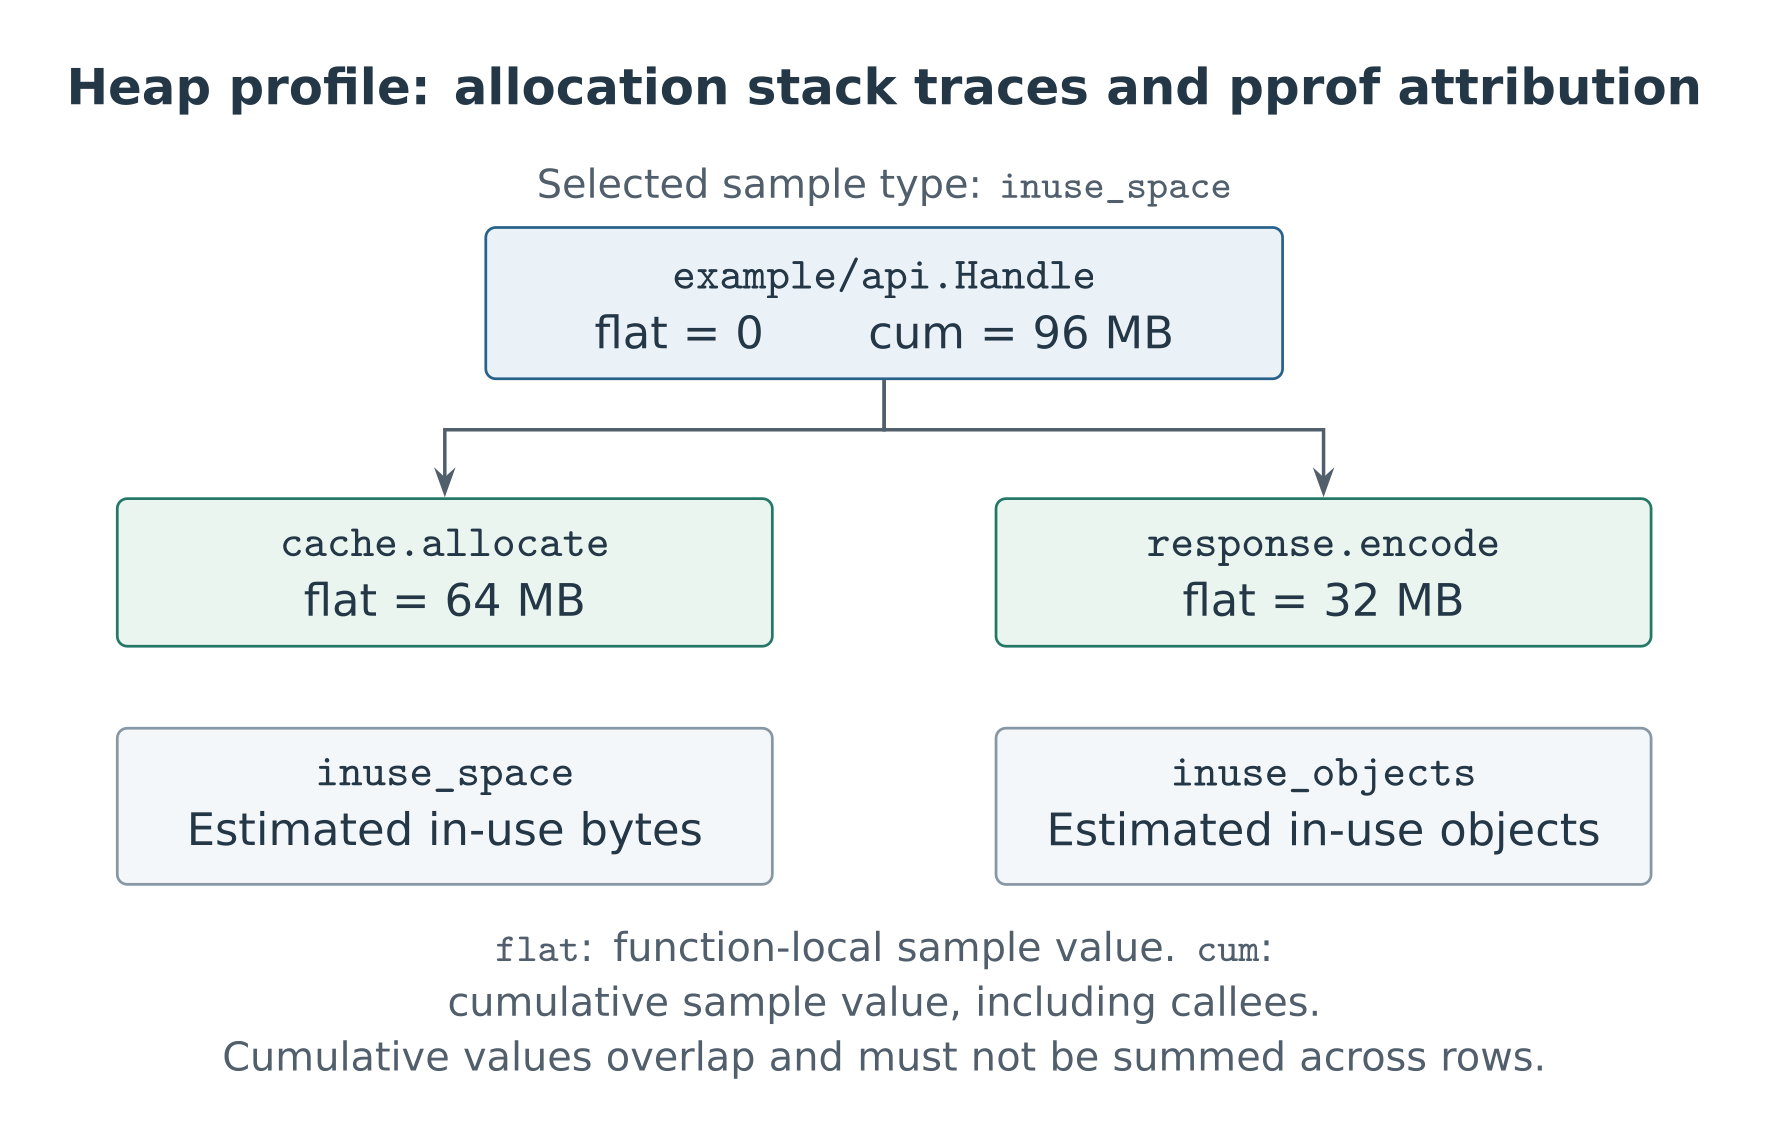
top 按函数聚合:flat 是直接归属该函数的权重,cum 包含经过该函数及下游调用的权重。示例中,Handle 未直接分配内存,两条下游路径合计 96 MB,因此其 flat=0、cum=96 MB。各行 cum 的统计范围可能重叠,不应逐行求和估计总量;sum% 为逐行累计的 flat%。pprof 使用说明
图 1:分配调用链与 pprof 展示的关系。
pprof 展示分配归因,不提供逐对象地址、类型、字段或引用关系。调用图、火焰图呈现的也是所选指标,而非堆中的对象排布。
表 1:pprof 样本类型、统计含义与用途。
| 样本类型 | 含义 | 用途 |
|---|---|---|
alloc_objects |
累计分配对象数,包含已释放对象 | 比较两个时点的分配增量 |
alloc_space |
累计分配字节数,包含已释放对象 | 定位临时对象分配热点 |
inuse_objects |
尚未记录释放的对象数 | 定位大量对象保留的分配位置 |
inuse_space |
尚未记录释放的字节数 | 定位主要内存占用来源 |
2.2 进程外采集的数据基础
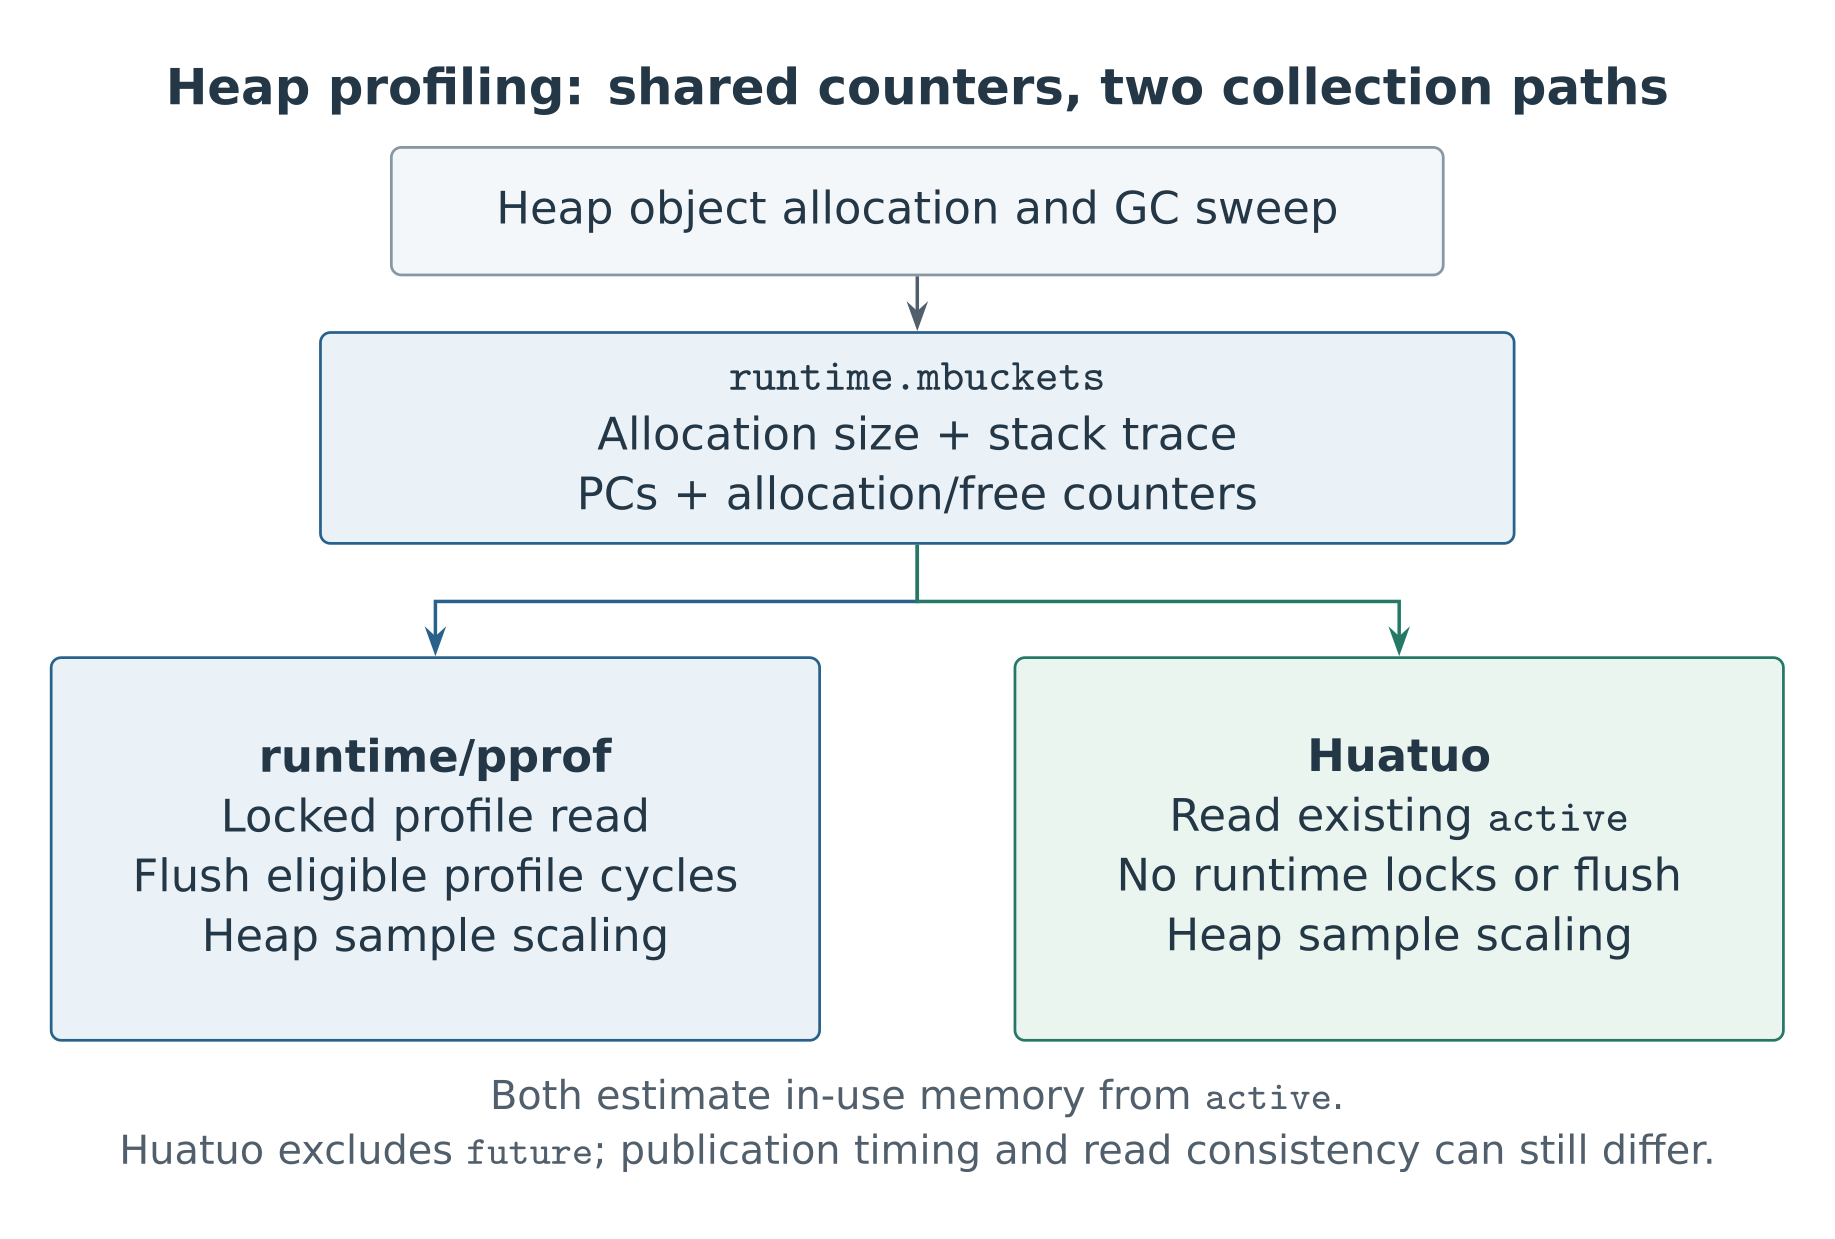
pprof heap 的数据来自以 runtime.mbuckets 为入口的统计链表,导出过程无需扫描全部业务堆对象。由此可将采集问题转化为:在目标进程已启用采样、运行时布局可识别且具备读取权限的条件下,从进程外定位、读取并解释这些统计。当前 Huatuo 仅使用已发布的 active 计数估算在用量,future 中的待发布事件不参与计算。
图 2:pprof 和 Huatuo 使用同一份 runtime 统计。
3. Go 堆采样统计模型
3.1 采样分配与释放事件的关联
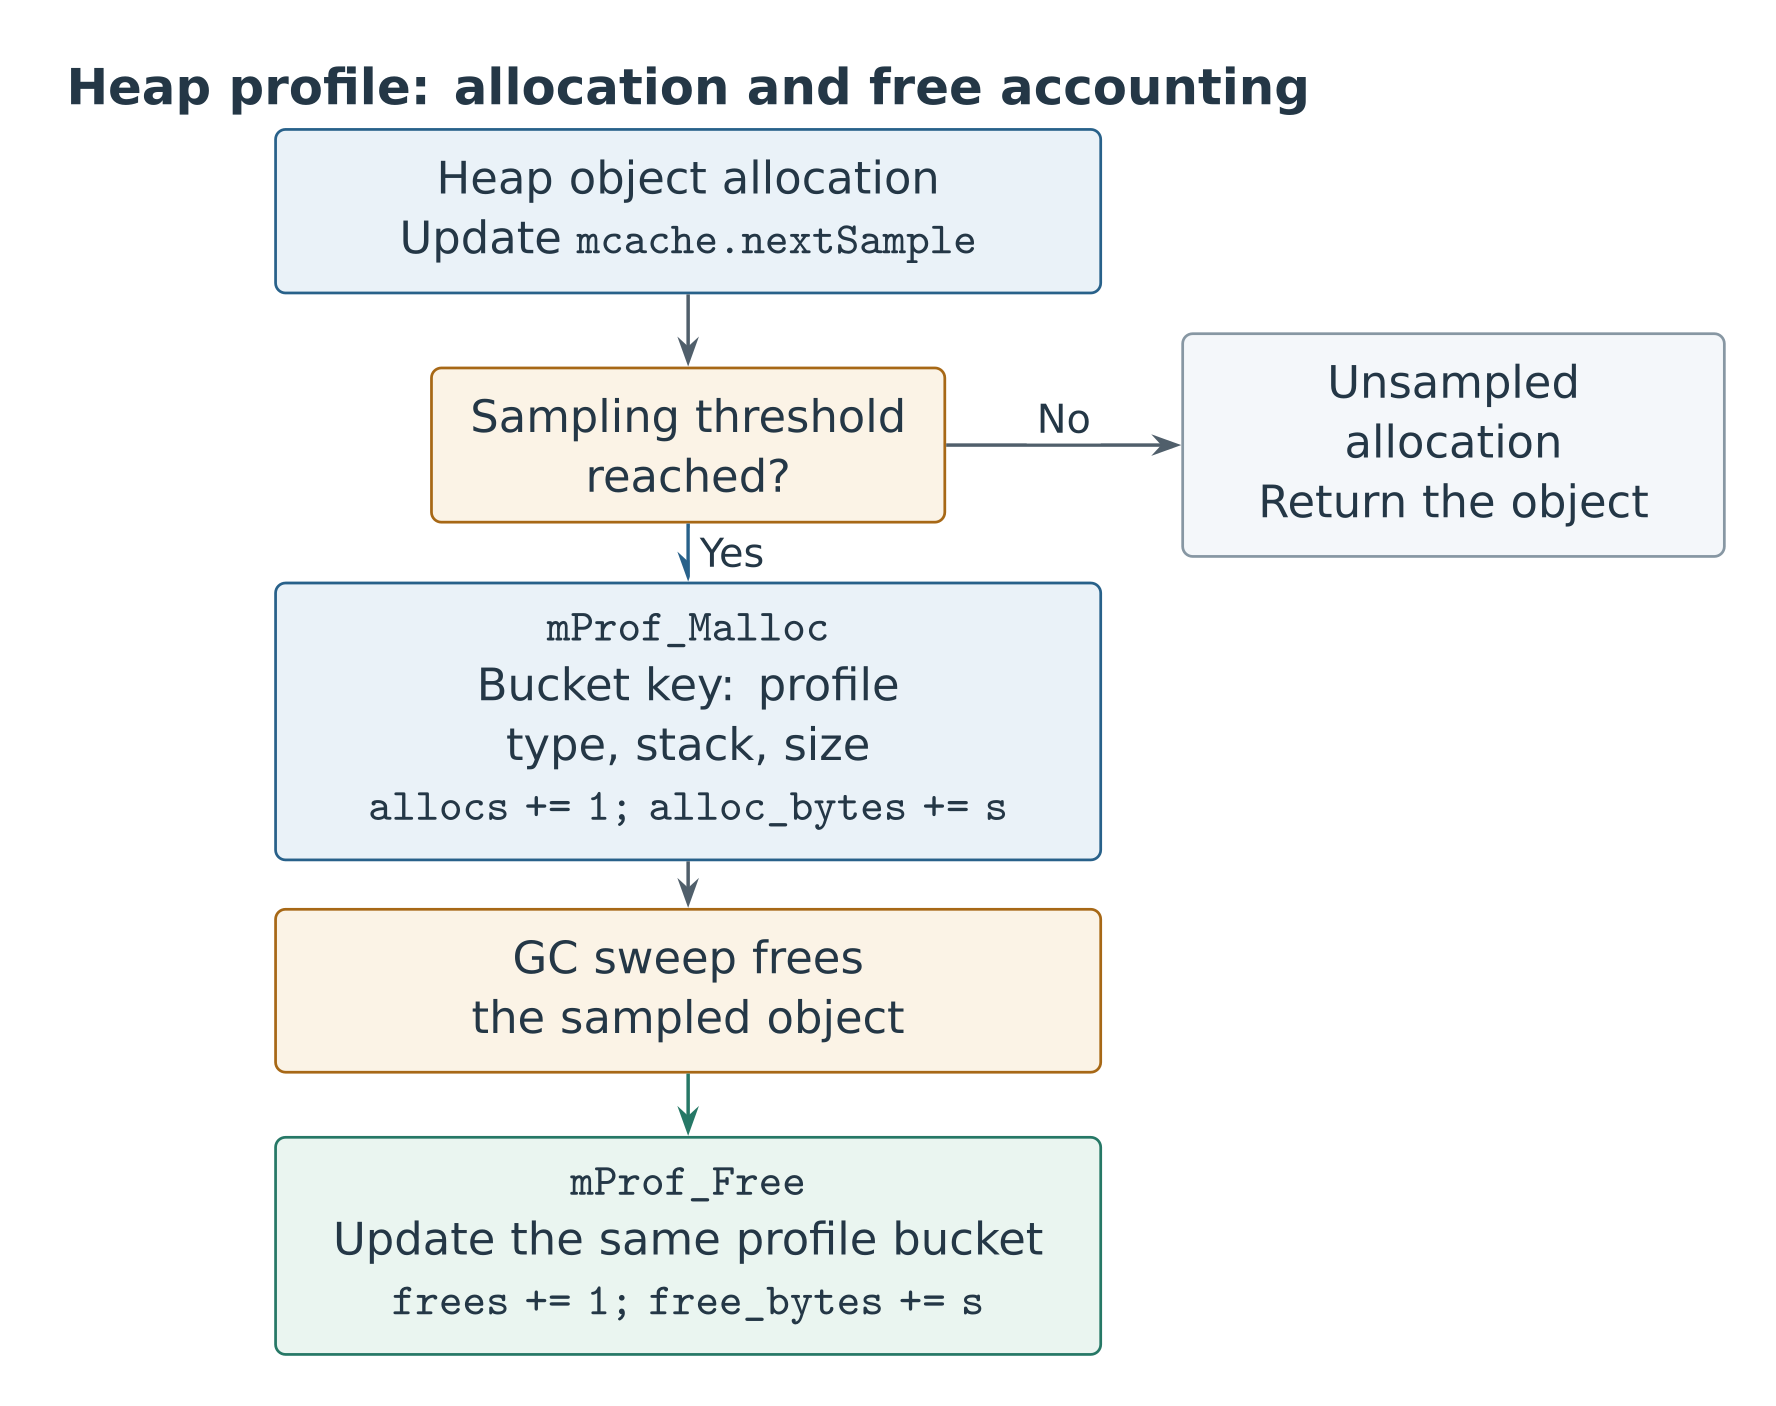
内存采样以 runtime 的堆分配块为单位。分配命中采样条件后,运行时获取分配调用栈,将分配次数和字节数记入对应 bucket。Sweep 回收该对象时,更新释放计数。
图 3:采样对象从分配到释放的记账流程。
3.2 采样概率与估计量
令 R=runtime.MemProfileRate,其单位为字节。runtime 按指数分布生成采样间隔,平均每分配约 R 字节遇到一个采样点;mcache.nextSample 保存剩余间隔,命中后重置。采集快照时不会重新抽样已有对象。
R=0:关闭采样。R=1:记录每个分配块。R>1:间隔越小,样本通常越多,栈捕获和记账成本也越高。
R>1 时,令 s 为分配块大小,单位同样为字节;p(s) 表示该分配块被采样记录的概率,exp(x)=e^x。在按累计分配字节数建立的泊松采样模型中,长度为 s 的区间没有采样点的概率为 exp(-s/R),因此至少命中一次的概率为:
|
|
图 4:采样概率函数 p(s) = 1 - exp(-s / R) 与小对象近似。
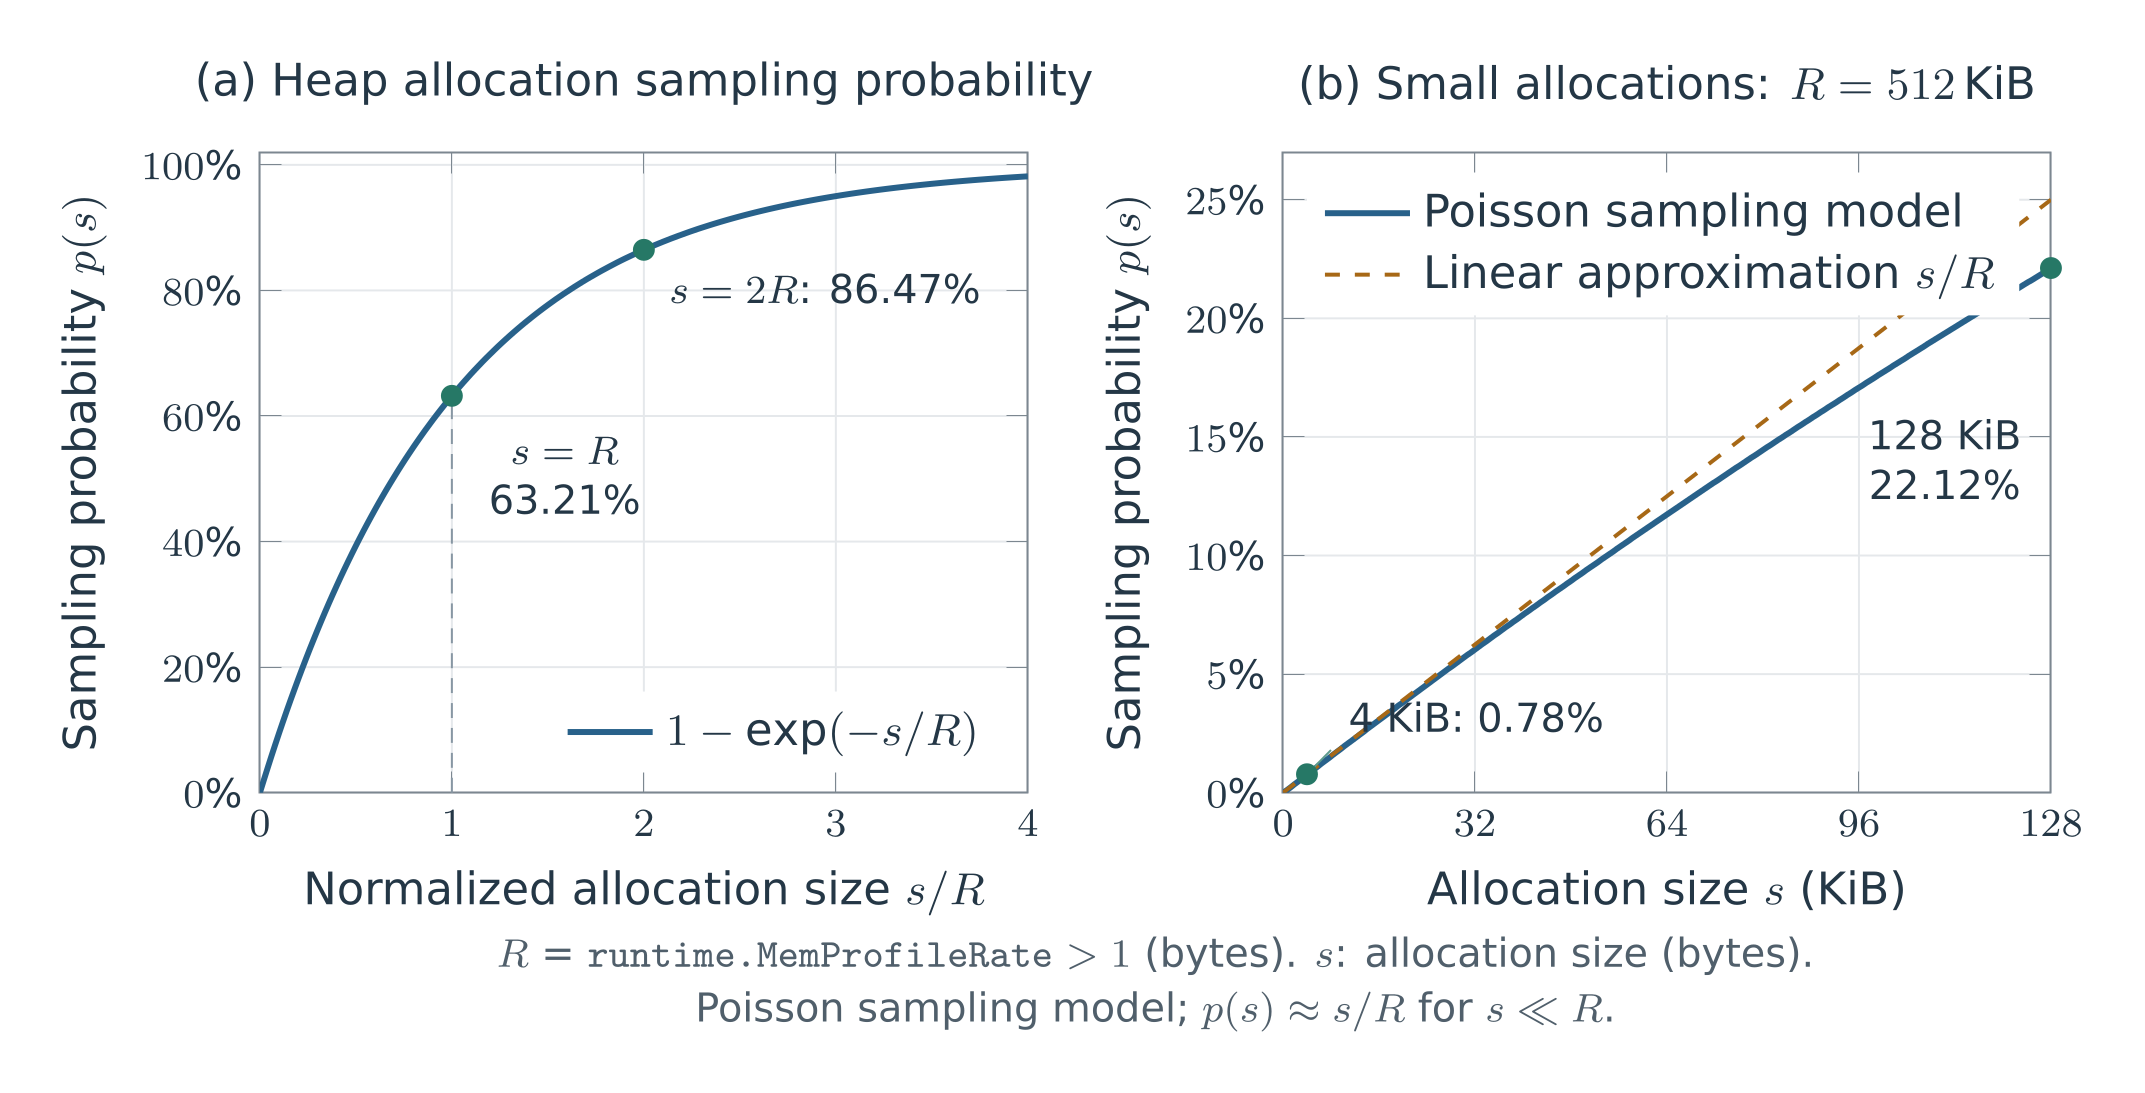
左图以 s/R 为横轴:R 是随机间隔的平均值,因此 s=R 时采样概率仅约为 63.21%,随后随分配大小增加而趋近 100%。右图固定 R=512 KiB,对比指数模型与线性近似 s/R;仅当 s 远小于 R 时,两者才接近。曲线来自概率模型,不是实验测量值。
例如 R=512 KiB:
表 2:R=512 KiB 时不同分配块大小的采样概率与校正权重。
| 分配块大小 | 采样概率 | 校正权重 |
|---|---|---|
| 4 KiB | 约 0.78% | 约 128.50 |
| 128 KiB | 约 22.12% | 约 4.52 |
| 512 KiB | 约 63.21% | 约 1.58 |
| 1 MiB | 约 86.47% | 约 1.16 |
对于同尺寸分配,设实际分配数量为 N,采样数量为 n,则模型给出 E[n]=N·p(s),对应估计量为 N̂=n/p(s)。例如,每个 4 KiB 样本的校正权重约为 128.50。该估计仍具有随机波动,样本量较少时不确定性较大。R=1 的全量记录无需放大,R=0 的关闭状态不适用此公式。
由于不同尺寸分配的采样概率不同,概率校正应按分配块大小分别进行。Huatuo 还需读取目标进程的实际采样率,配置生效顺序见第 3.3 节,历史采样率变化的影响见第 5.1 节。nextSample、scaleHeapSample
3.3 采样启用条件与配置覆盖
runtime.MemProfile 用于读取统计,是否持续采样取决于运行时实际的 MemProfileRate。本节依据 Go 1.26 官方文档、源码分析覆盖关系。
表 3:影响堆采样启用的配置与链接条件(Go 1.26)。
| 影响因素 | 对采样启用的影响 |
|---|---|
| 源码初始值 | 初始为 512 * 1024,但启动期间可能被覆盖,不保证每个程序默认开启。变量定义 |
启动时的 GODEBUG |
memprofilerate=N 设置采样率,0 关闭;之后仍可能被 runtime 或应用覆盖。解析逻辑 |
| profile 读取路径的可达性 | runtime.memProfileInternal 不可达且满足链接模式条件时,链接器设置 disableMemoryProfiling,runtime 启动时把采样率清零。可达性是构建时的引用关系,不要求运行时已执行读取。链接器逻辑 |
| Go 链接模式 | 自动关闭要求 !DynlinkingGo();Go shared、-linkshared、plugin 等情况会影响判断。仅凭是否使用 cgo 或动态链接 libc,不能推断该条件。模式判断 |
| 应用或依赖库赋值 | 在 init()、main() 等位置设置正数可开启采样,设为 0 可关闭;也能重新开启启动时被清零的采样。应尽早设置一次并保持不变。使用约定 |
| 测试程序参数 | go test -memprofilerate=N 在测试开始前设置采样率;Go 1.26 仅在 N>0 时赋值,N=0 表示不覆盖当前值。testing 实现 |
图 5:采样率的覆盖顺序与最终启用条件(Go 1.26)。
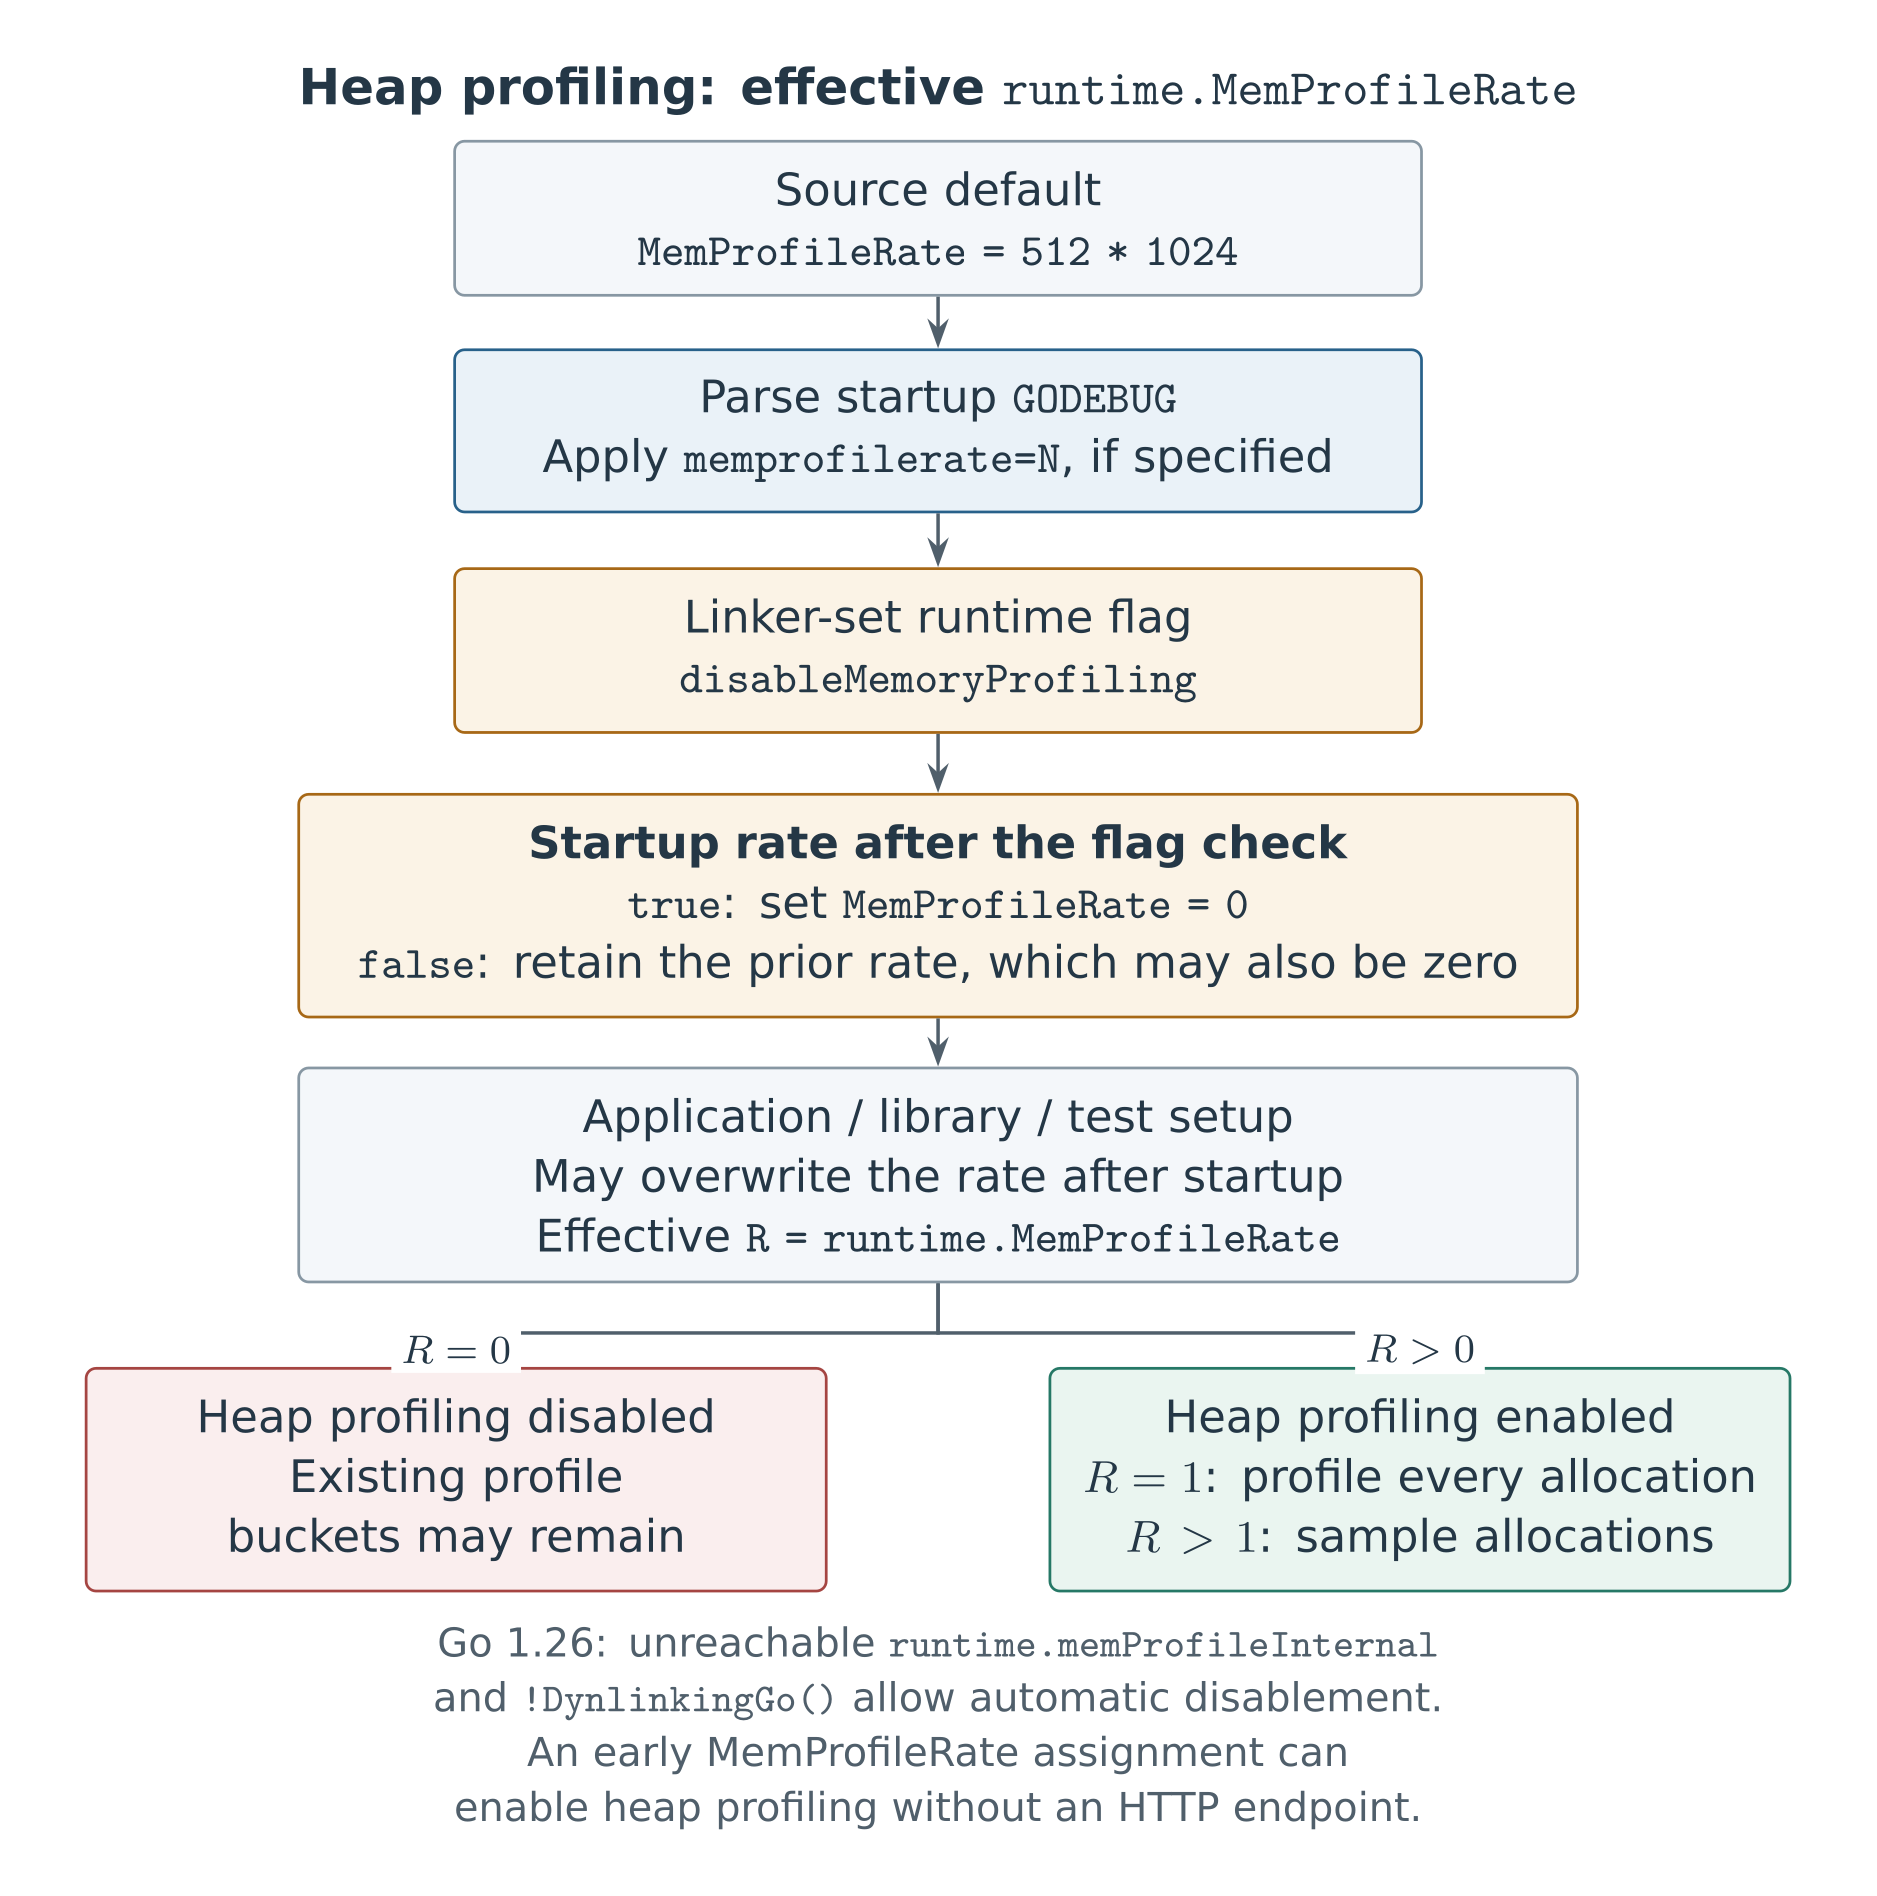
runtime 在解析启动配置后检查 disableMemoryProfiling:为 true 时将 MemProfileRate 清零;为 false 时保留此前的值,该值也可能为 0。因此,标志为 false 不等于采样已开启,仅设置正数 GODEBUG=memprofilerate=... 也不能保证开启。应用随后可通过赋值 MemProfileRate 开启采样,无需显式调用 runtime.MemProfile 或启动 HTTP 服务。此操作仅影响后续分配,不能恢复此前未采样的分配历史。启动顺序、分配采样逻辑
官方 TestMemProfileCheck 验证:使用 runtime.MemProfile、pprof.WriteHeapProfile、pprof.Lookup("heap")、pprof.Profiles(),以及仅 import _ "net/http/pprof",都可以保留默认采样路径。它们是否可达可能由业务依赖间接决定;如果采样率又被设为 0,仍不会持续采样。官方测试
3.4 bucket 的聚合键与遍历关系
runtime 按 (profile 类型, 完整分配栈, 分配大小) 分桶。同一栈分配不同大小的块会进入不同 bucket;相同大小的多个样本可以共用一个 bucket。对象回收只增加释放计数,不删除 bucket。
图 6:哈希链用于查找,allnext 链用于遍历。
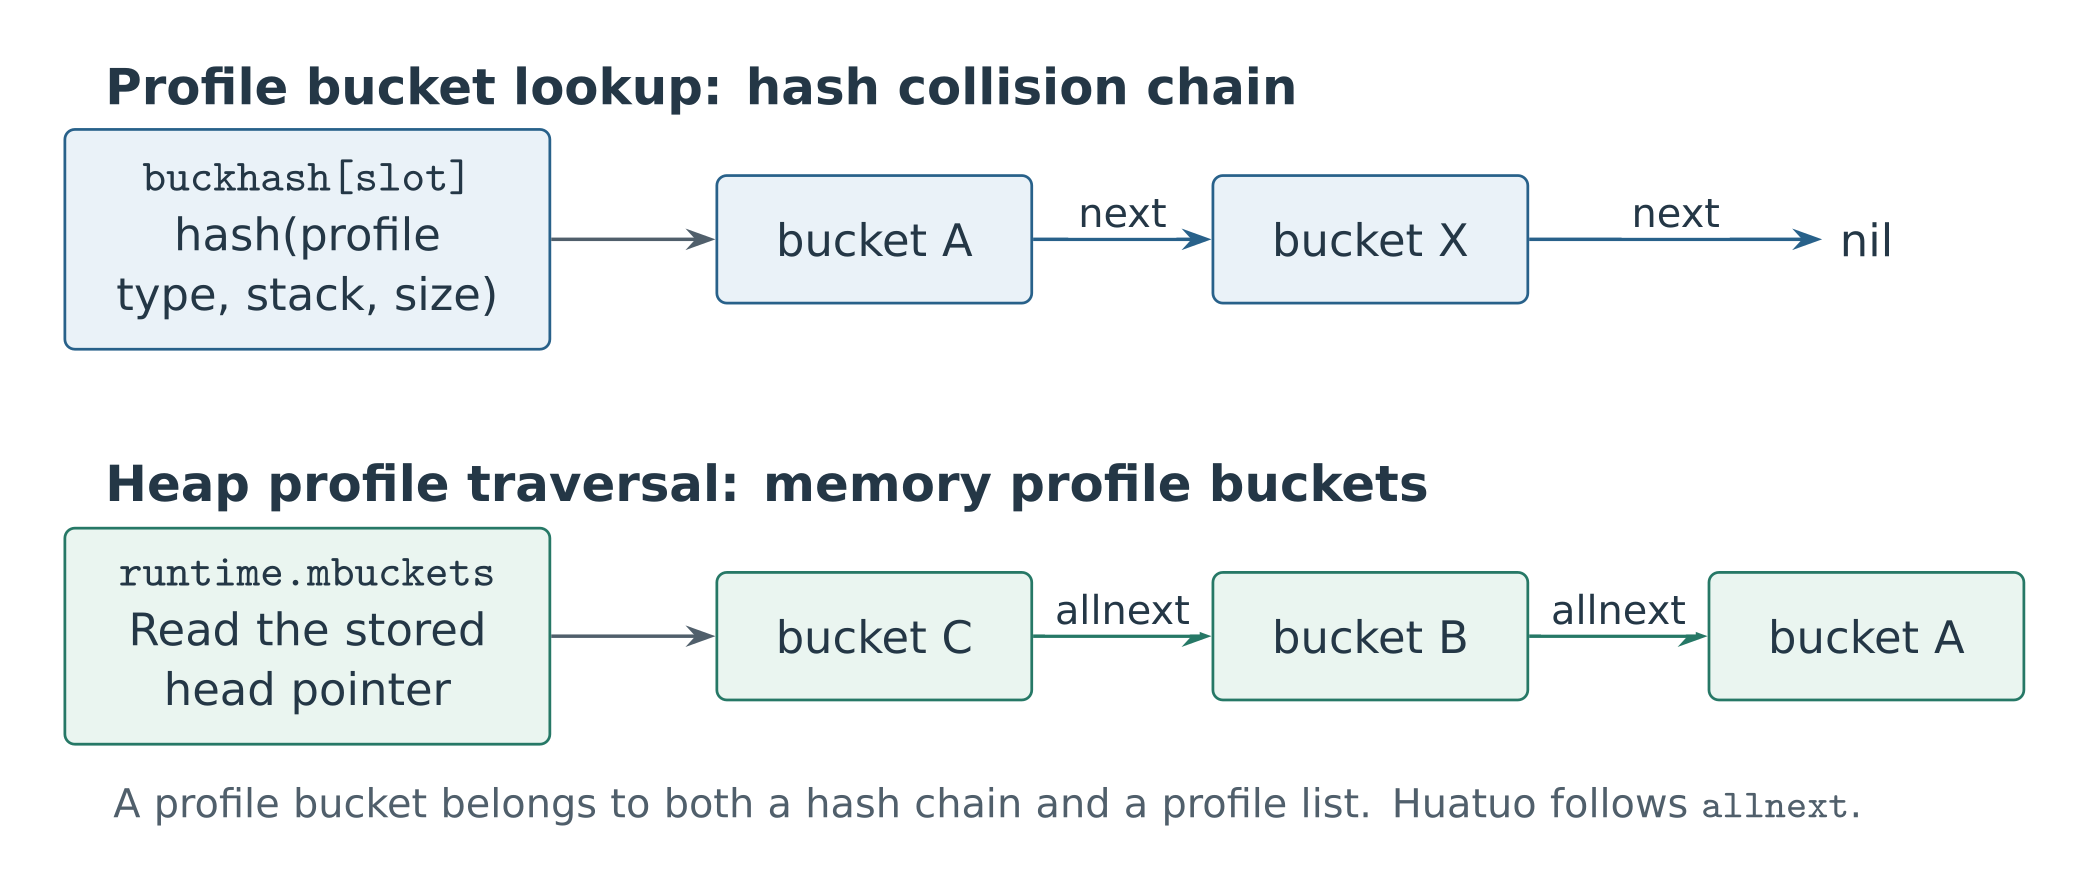
Huatuo 先读取 runtime.mbuckets 变量中保存的头指针,再沿 allnext 遍历。next 连接同一哈希槽中的冲突节点,其遍历语义与 allnext 不同。bucket 由持久分配器分配,新节点插到链表头;已有节点的头部、栈和链接不变,计数持续更新。bucket、stkbucket
3.5 bucket 内存布局与计数字段
在本文考察的 64 位布局中,bucket 由 48 字节头部、nstk 个 PC 和 128 字节计数记录连续组成。PC 区不是 slice header,也不按最大栈深预留空间。
图 7:bucket 的内存布局,偏移单位为字节。
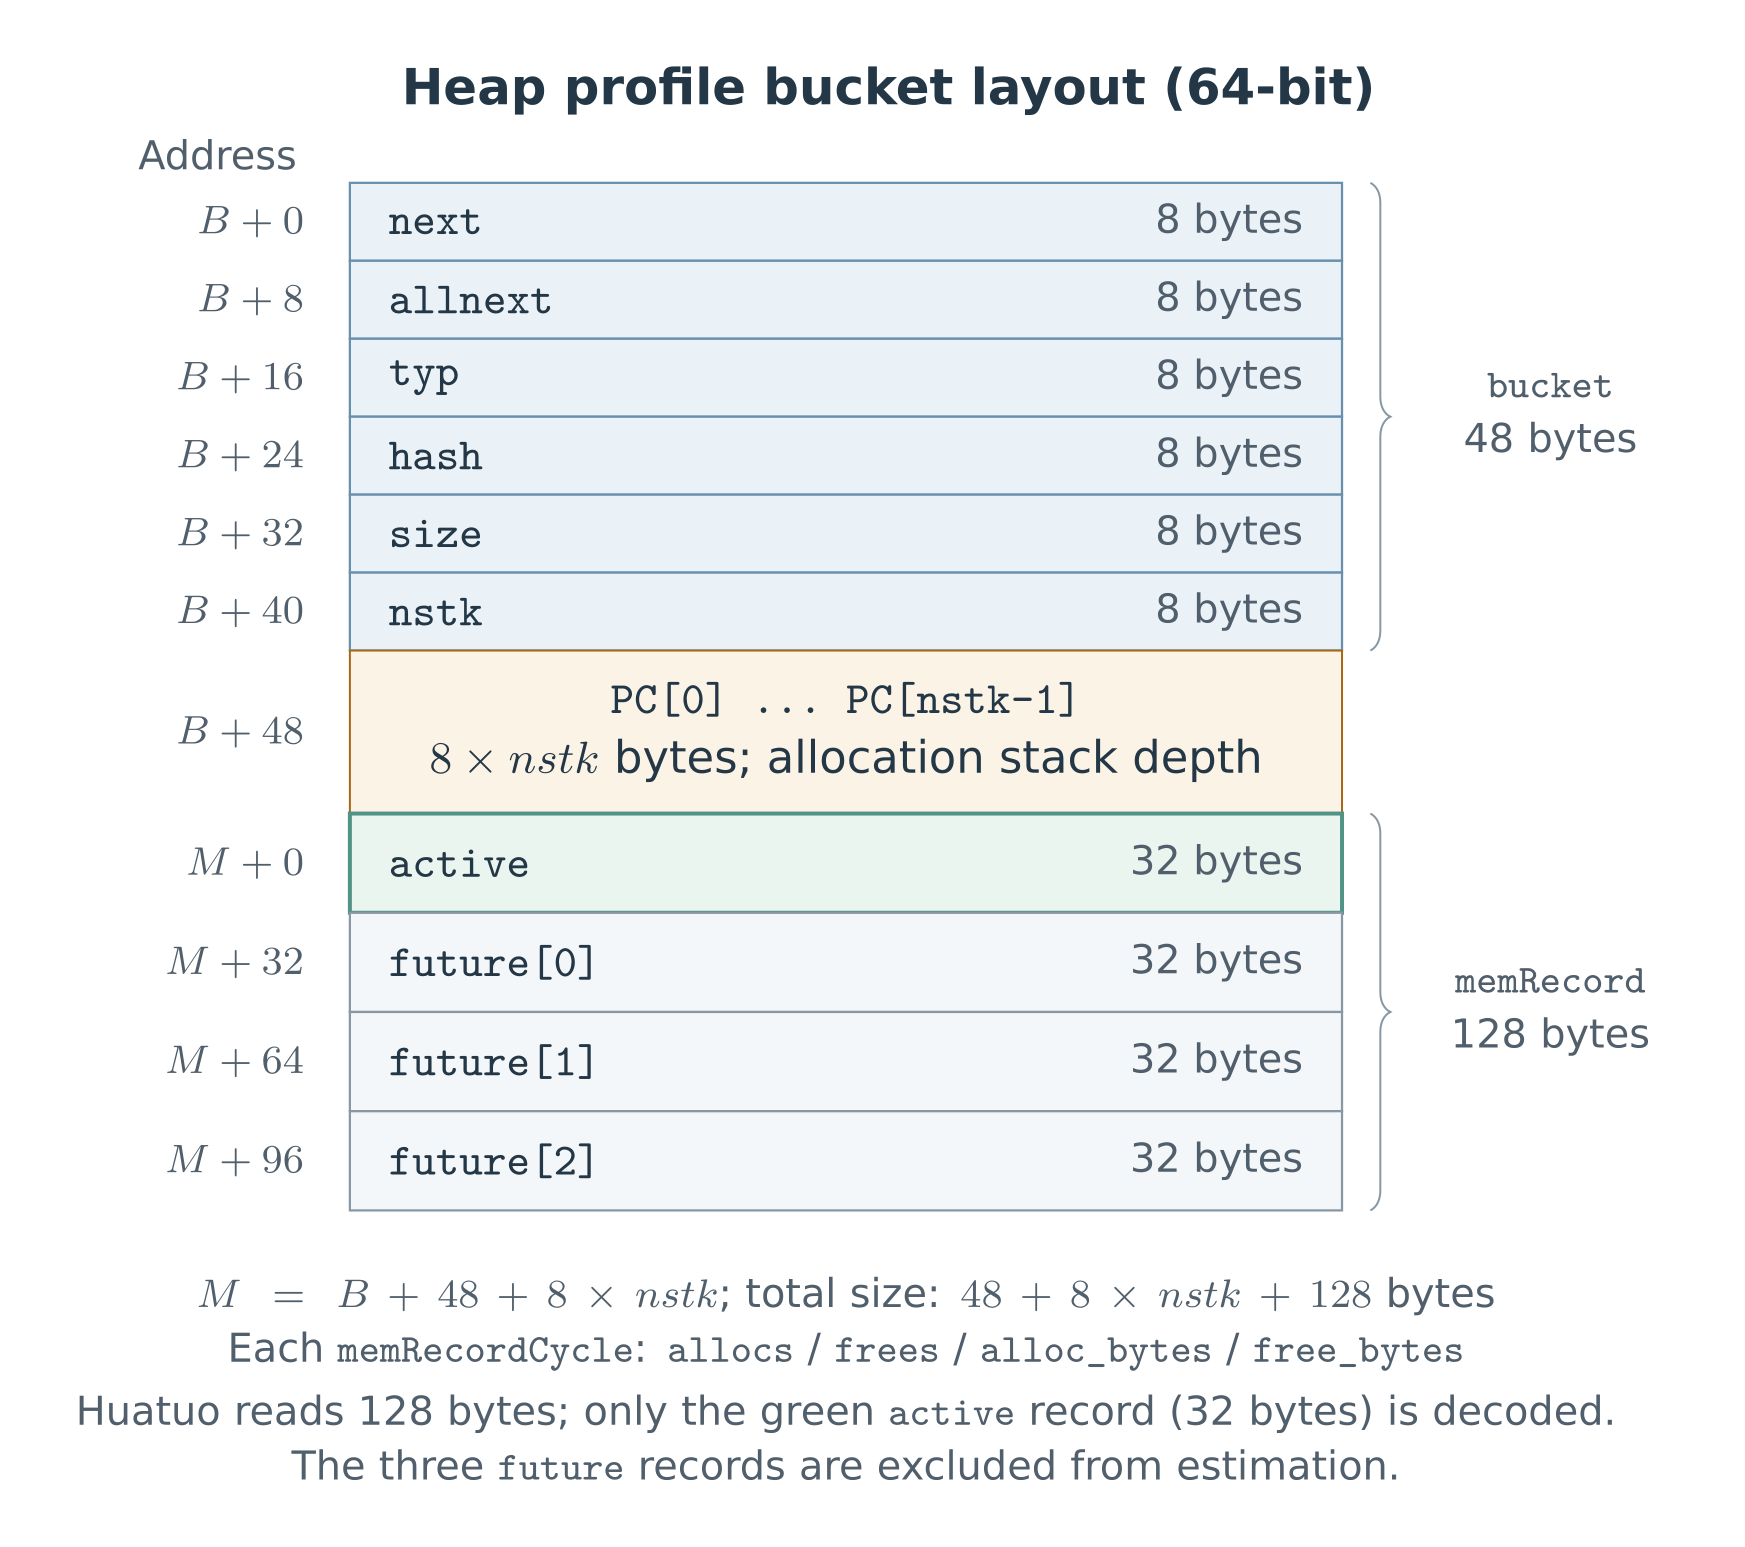
每份 memRecordCycle 都有四个 uintptr 样本计数:
表 4:64 位 memRecordCycle 的字段布局。
| 相对偏移 | 字段 | 含义 |
|---|---|---|
| 0 | allocs |
分配次数 |
| 8 | frees |
已记录释放次数 |
| 16 | alloc_bytes |
分配字节数 |
| 24 | free_bytes |
已记录释放字节数 |
active 保存已发布的累计值,三个 future 槽保存不同周期的增量,四份记录具有不同的统计时间范围。Go 1.26 布局
|
|
3.6 GC 周期与统计发布机制
分配事件在采样命中后记账,释放事件则在 Sweep 阶段记账。标记终止(mark termination,MT)时,本轮释放统计尚未完成。active/future 用于对齐分配与释放事件的统计边界,相关锁用于保护并发更新。
以下分析以 Go 1.26.0 默认并发 GC 为依据。设全局 heap profile 周期为 C;
表 5:分配、释放与发布事件的计数更新位置。
| 事件 | 记账位置 | 更新 |
|---|---|---|
采样分配 mProf_Malloc |
future[(C+2)%3] |
增加分配次数、字节数 |
Sweep 释放 mProf_Free |
future[(C+1)%3] |
增加释放次数、字节数 |
正常发布 mProf_Flush |
future[C%3] → active |
四个计数分别累加,然后清零该槽 |
数组本身不移动,也不与 active 交换地址。C 增加时,三个物理槽位轮流承担“可发布、接收释放、接收分配”三个角色。可发布数据需要独立槽位,是因为周期在 STW 内推进,耗时的 flush 留到恢复运行后执行。
分配与释放的槽位偏移通过 MT 完成对齐:当 C=k 时,分配写入 k+2;MT 将周期推进至 C=k+1 后,Sweep 释放写入 (k+1)+1=k+2,两类事件因而进入同一物理槽位。
图 8:同一组样本从分配、回收到发布的时间线;圆点表示 10 个采样对象。
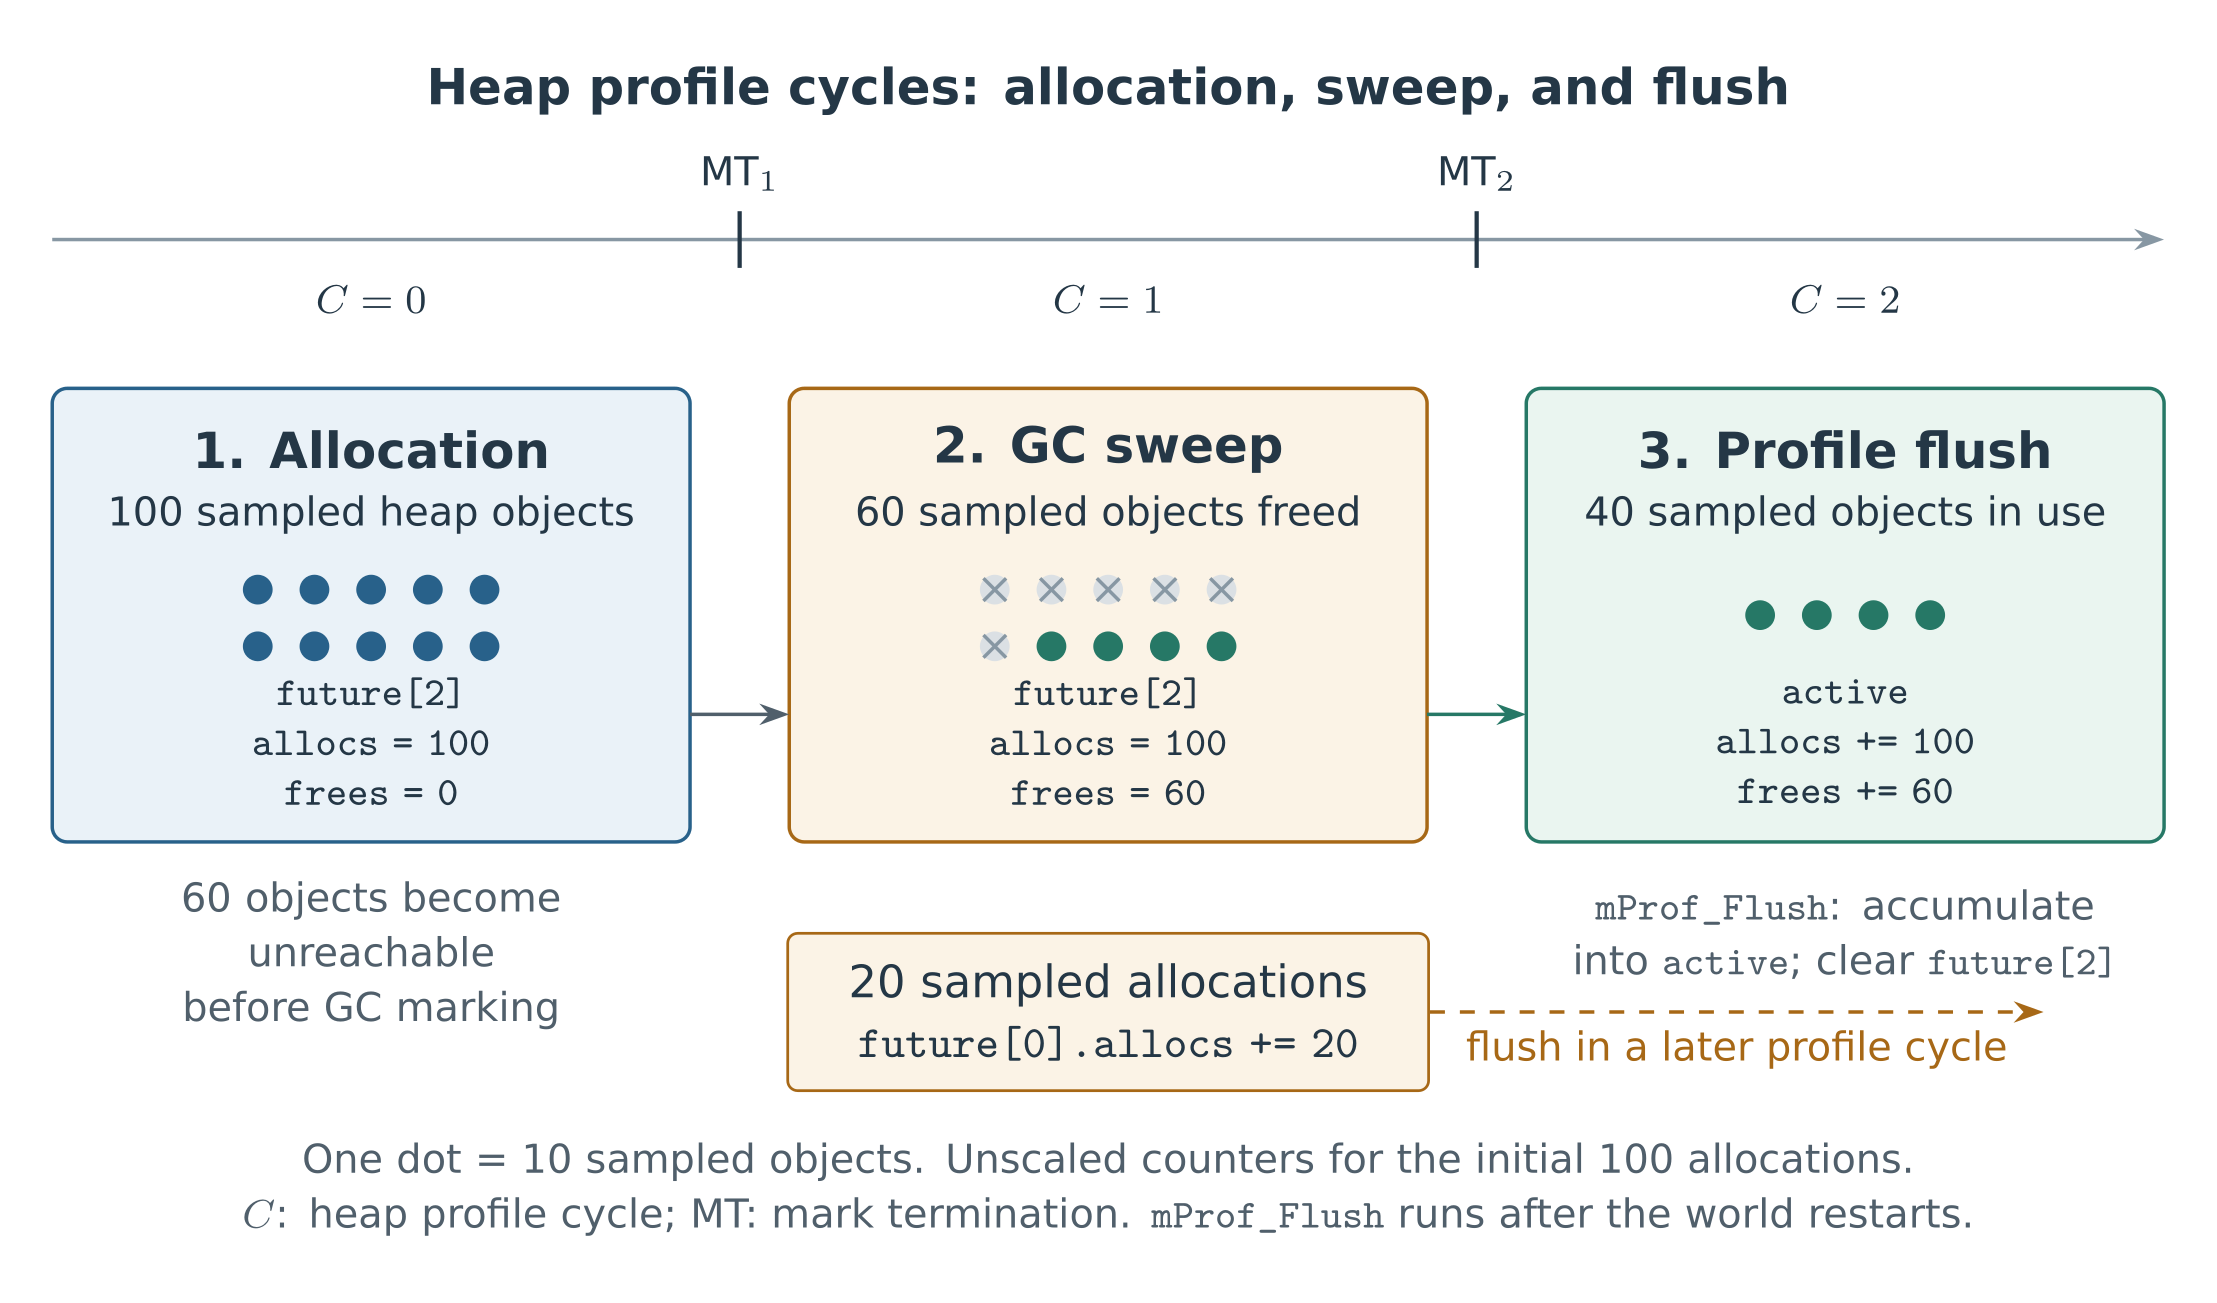
图中省略已有累计数据。正常发布条件由 GC 阶段顺序保证:下一轮标记前先完成上一轮 Sweep,因此到 MT₂ 时,MT₁ 对应的释放事件已完成记账。长寿命对象的分配可能早已进入 active,释放则在后续周期补入同一 bucket。
这些计数经概率校正后对应 pprof 的四种值:
|
|
Huatuo 仅从 active 读取累计分配与释放计数,计算差值并进行概率校正。future 的增量须经 runtime 发布后才参与估算,从而保留分配与释放的周期对齐机制。
4. Huatuo 进程外采集方法
4.1 进程身份与地址空间解析
Huatuo 使用 TGID + StartTimeTicks 校验进程身份,打开 /proc/<pid>/exe 读取 ELF 和 Go build info,并保持文件句柄到符号化结束。当前接受 ELF64、Go 1.18–1.26,按目标字节序解码;剥离符号恢复仅支持 AMD64。
图 9:一次采集的数据流。
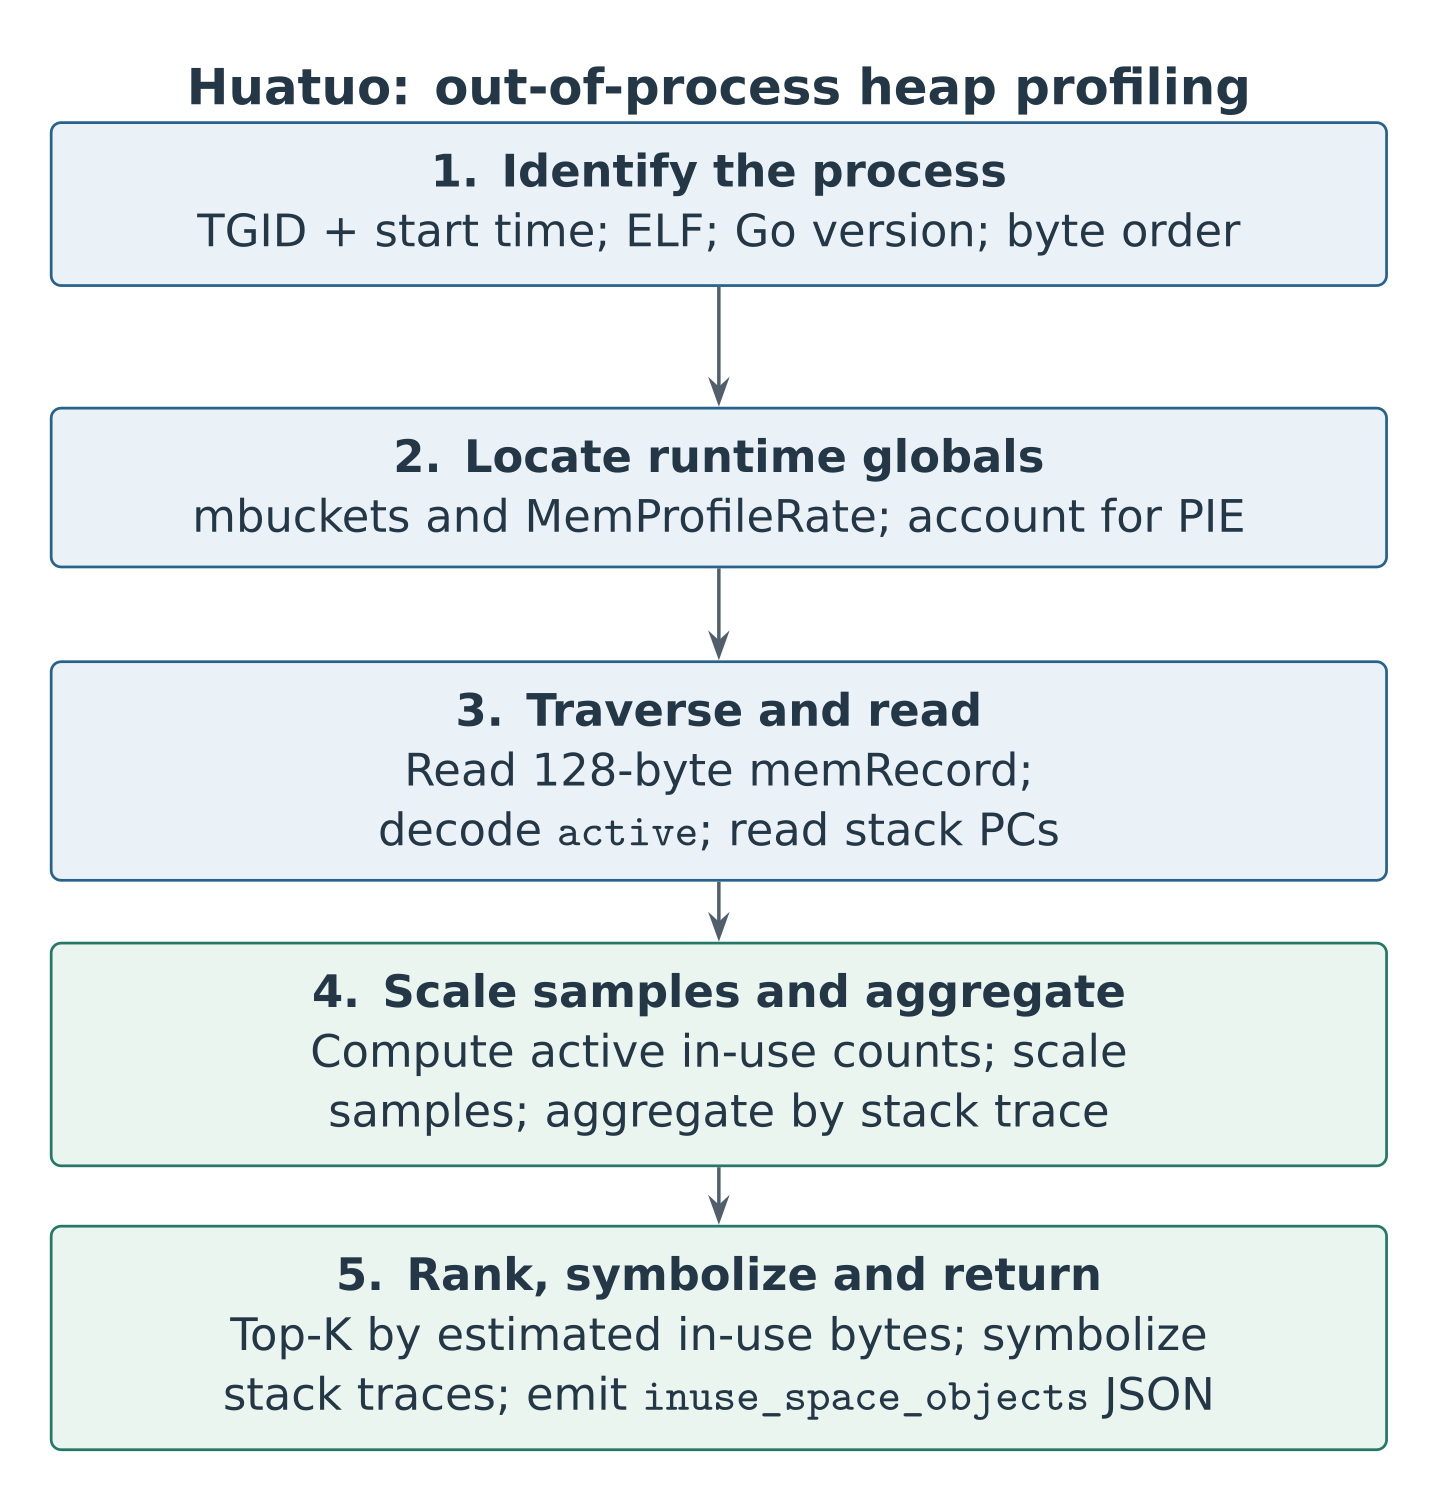
PIE 的运行时地址需结合 /proc/<pid>/maps、可执行文件标识和 PT_LOAD 段计算:
|
|
减去 1 用于将返回 PC 定位至调用指令所在范围。对应实现为 process_linux.go 的 resolveExecutableLoadBias、runtime.go 的 newRuntimeInfo 和 symbols.go 的 resolve。
4.2 全局变量定位与采样率读取
采集器首先从 ELF .symtab、.dynsym 查找 runtime.mbuckets 和 runtime.MemProfileRate,解析受元数据预算约束。变量符号缺失时,AMD64 路径用 pclntab 找到访问变量的 runtime 函数,再解码机器指令;pclntab 本身不提供全局变量地址。
图 10:剥离 ELF 符号后的地址恢复。
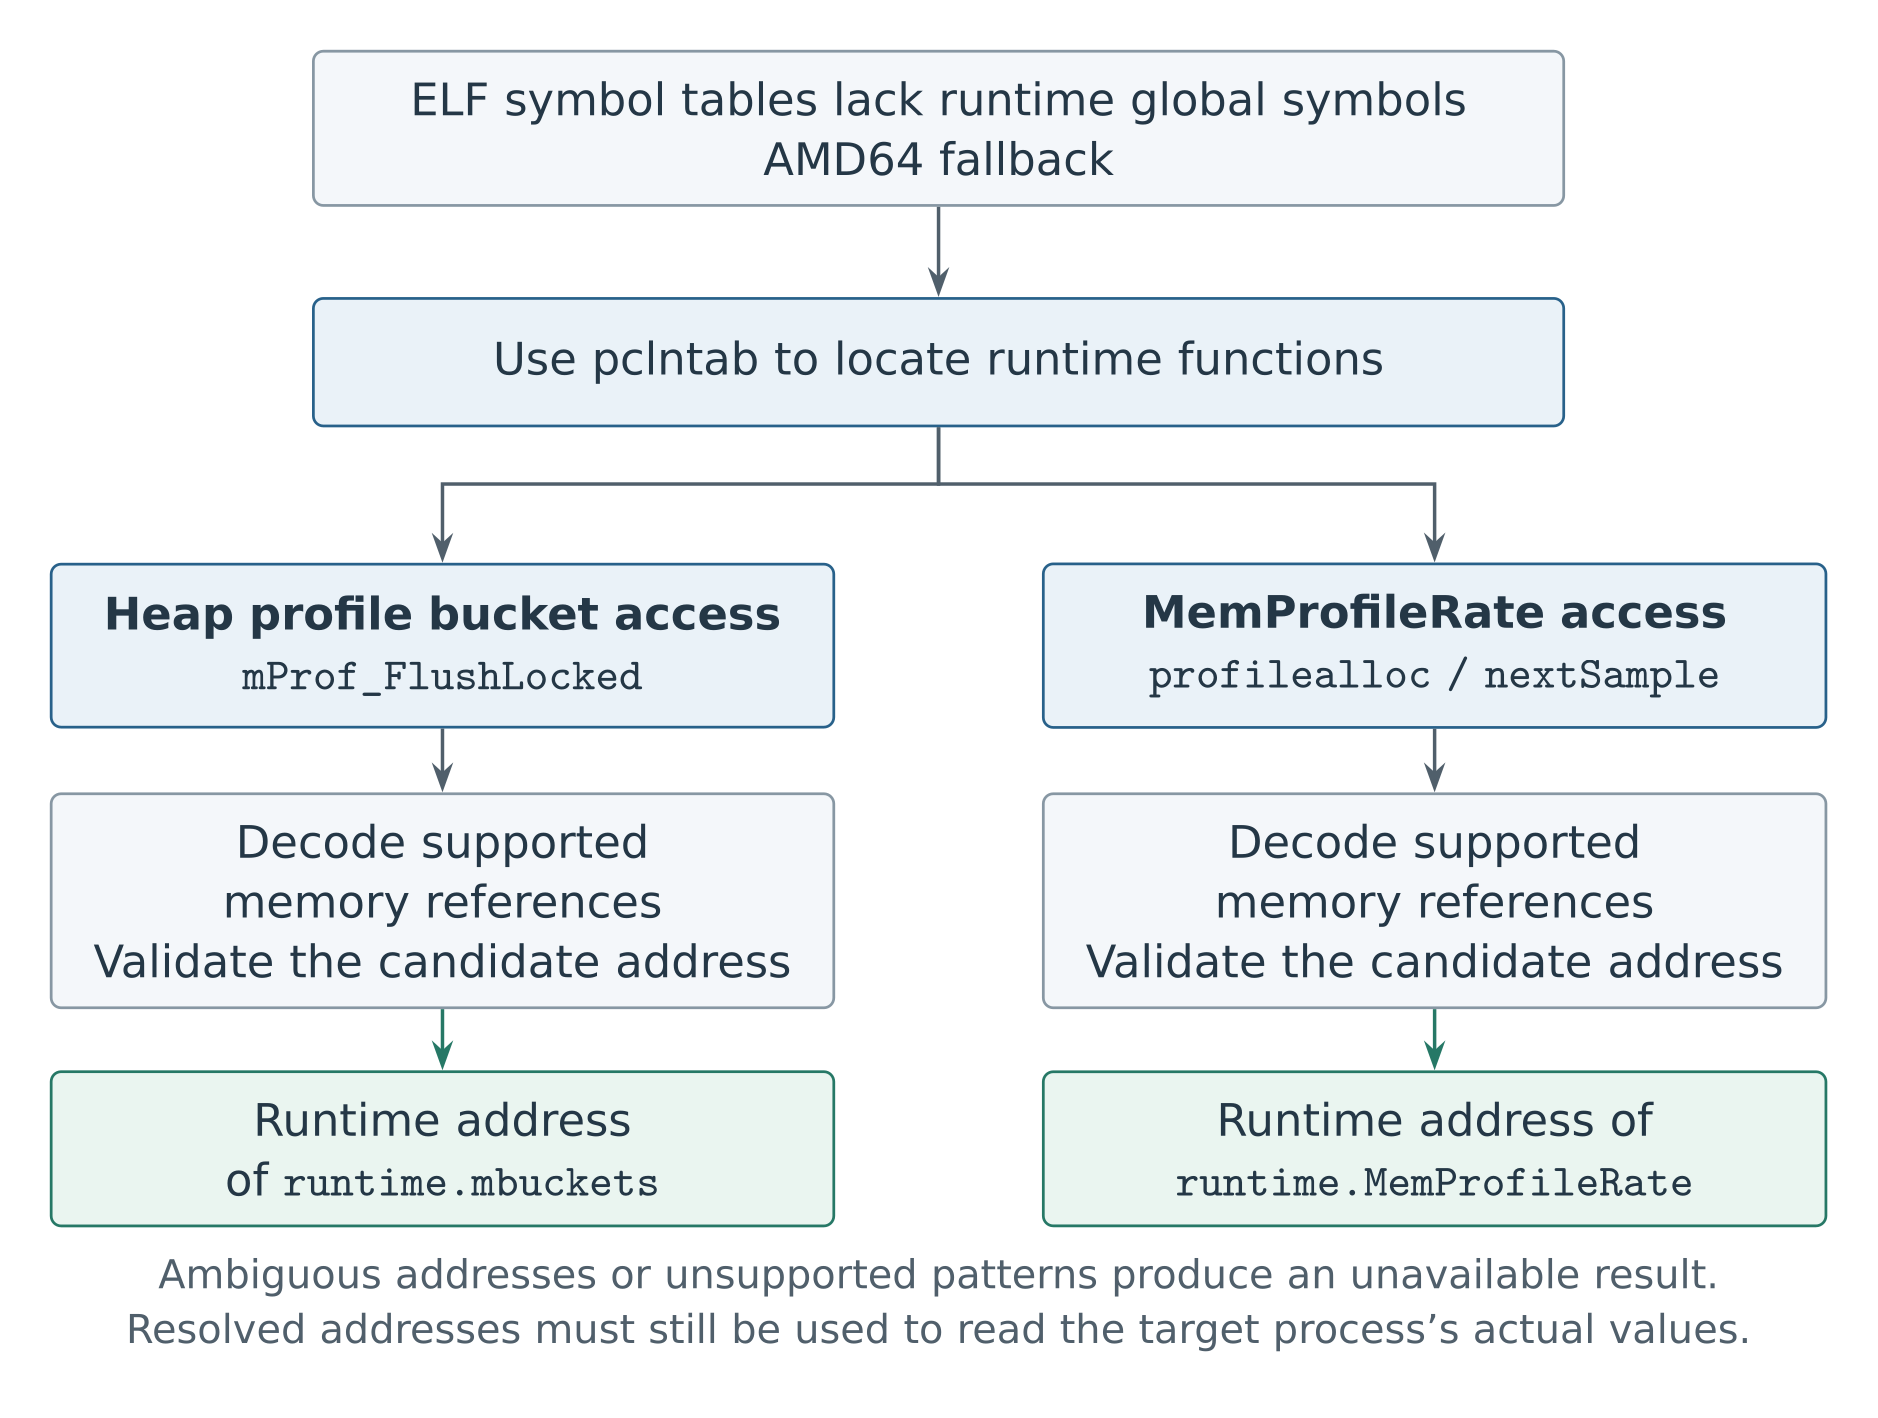
地址存在歧义或指令模式不匹配时,采集器返回不可用;定位成功后仍须读取实际采样率。R=0 表示采样关闭,采样率读取失败时不能用默认值替代。这种恢复依赖编译器指令模式,不保证适配任意混淆、加壳或定制工具链。实现见 stripped_symbols.go、internal/symbol/elf_symbols.go。
4.3 bucket 遍历与批量读取
链表地址需逐节点获取。Huatuo 沿 allnext 读取 48 字节头部,每批最多 64 个 bucket。readMemRecords 仍为每个 bucket 读取完整的 128 字节 memRecord,但 decodeCounters 只解释前 32 字节的 active。因此,“仅使用 active”指统计口径,底层读取长度并未缩减为 32 字节。随后仅为在用对象数、字节数和栈深均非零的 bucket 读取调用栈。
图 11:三阶段读取,批次之间复用缓冲区。
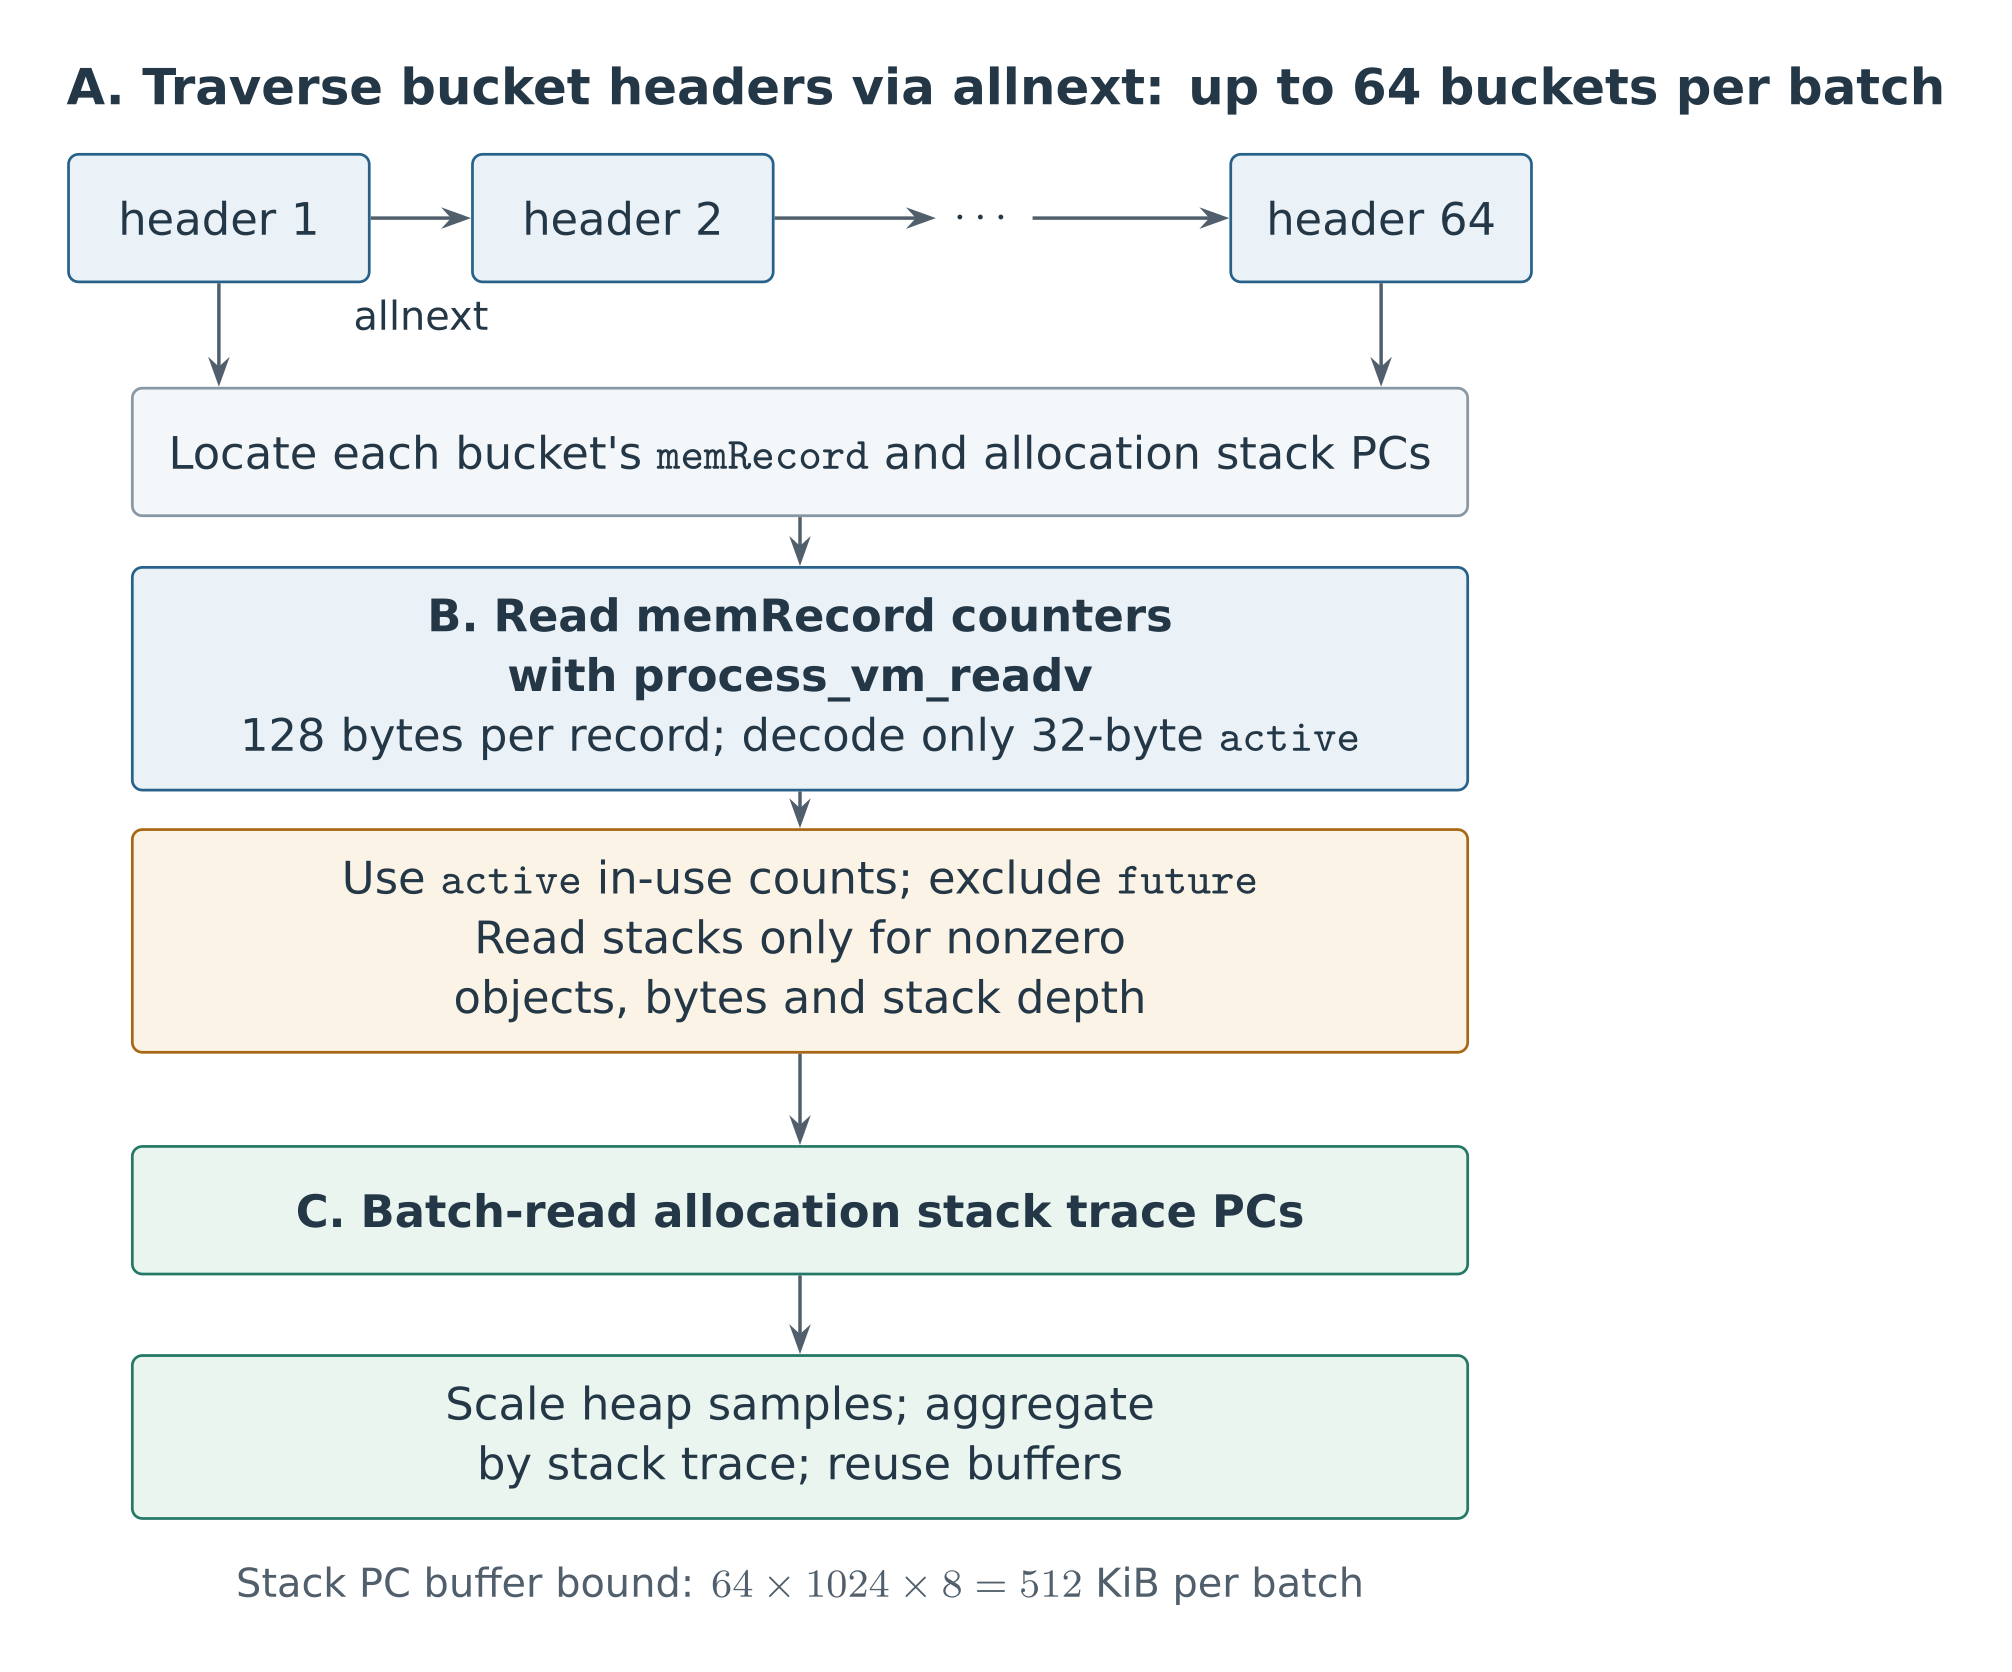
每批 PC 缓冲区最多 64 × 1024 × 8 = 512 KiB,聚合表保留的栈键会复制。批量读取减少记录和栈的系统调用次数,头部读取仍随 bucket 数线性增长。实现见 memory_linux.go、bucket.go;读取一致性见第 4.4 节。
4.4 在用样本计算与读取一致性
runtime_layout.go 的 decodeCounters 仅使用 memRecord.active 的四个计数:
|
|
future[0..2] 不参与差值计算。以图 8 为例,100 次分配和 60 次释放发布至 active 后,贡献 40 个在用样本;新分配的 20 个样本仍在 future[0],本次估算不计入。该口径保留 runtime 的发布延迟,避免提前纳入尚未与 Sweep 释放对齐的新分配。
Huatuo 读取当时已发布的数据,不获取 runtime 锁,也不主动 flush 待发布周期。标准 MemProfile/pprof 则在锁内处理可发布周期后读取 active,在尚无已发布历史数据时还可能合并 future。因此,两者以同一类已发布统计为基础,但不能保证采集时点和结果完全一致。memProfileInternal
仅使用 active 仍不构成原子读取:flush 会更新多个字段并遍历多个 bucket,进程外读取可能观察到不同更新阶段。图 12 以未校正的对象计数为例,发布前 allocs=100、frees=60,本次增量为分配 20、释放 10。完整发布后的在用数为 50;若读到新分配计数与旧释放计数,结果为 60;反向混合则为 30。
图 12:仅使用 active 时,跨字段并发读取仍可能得到不一致的在用计数。
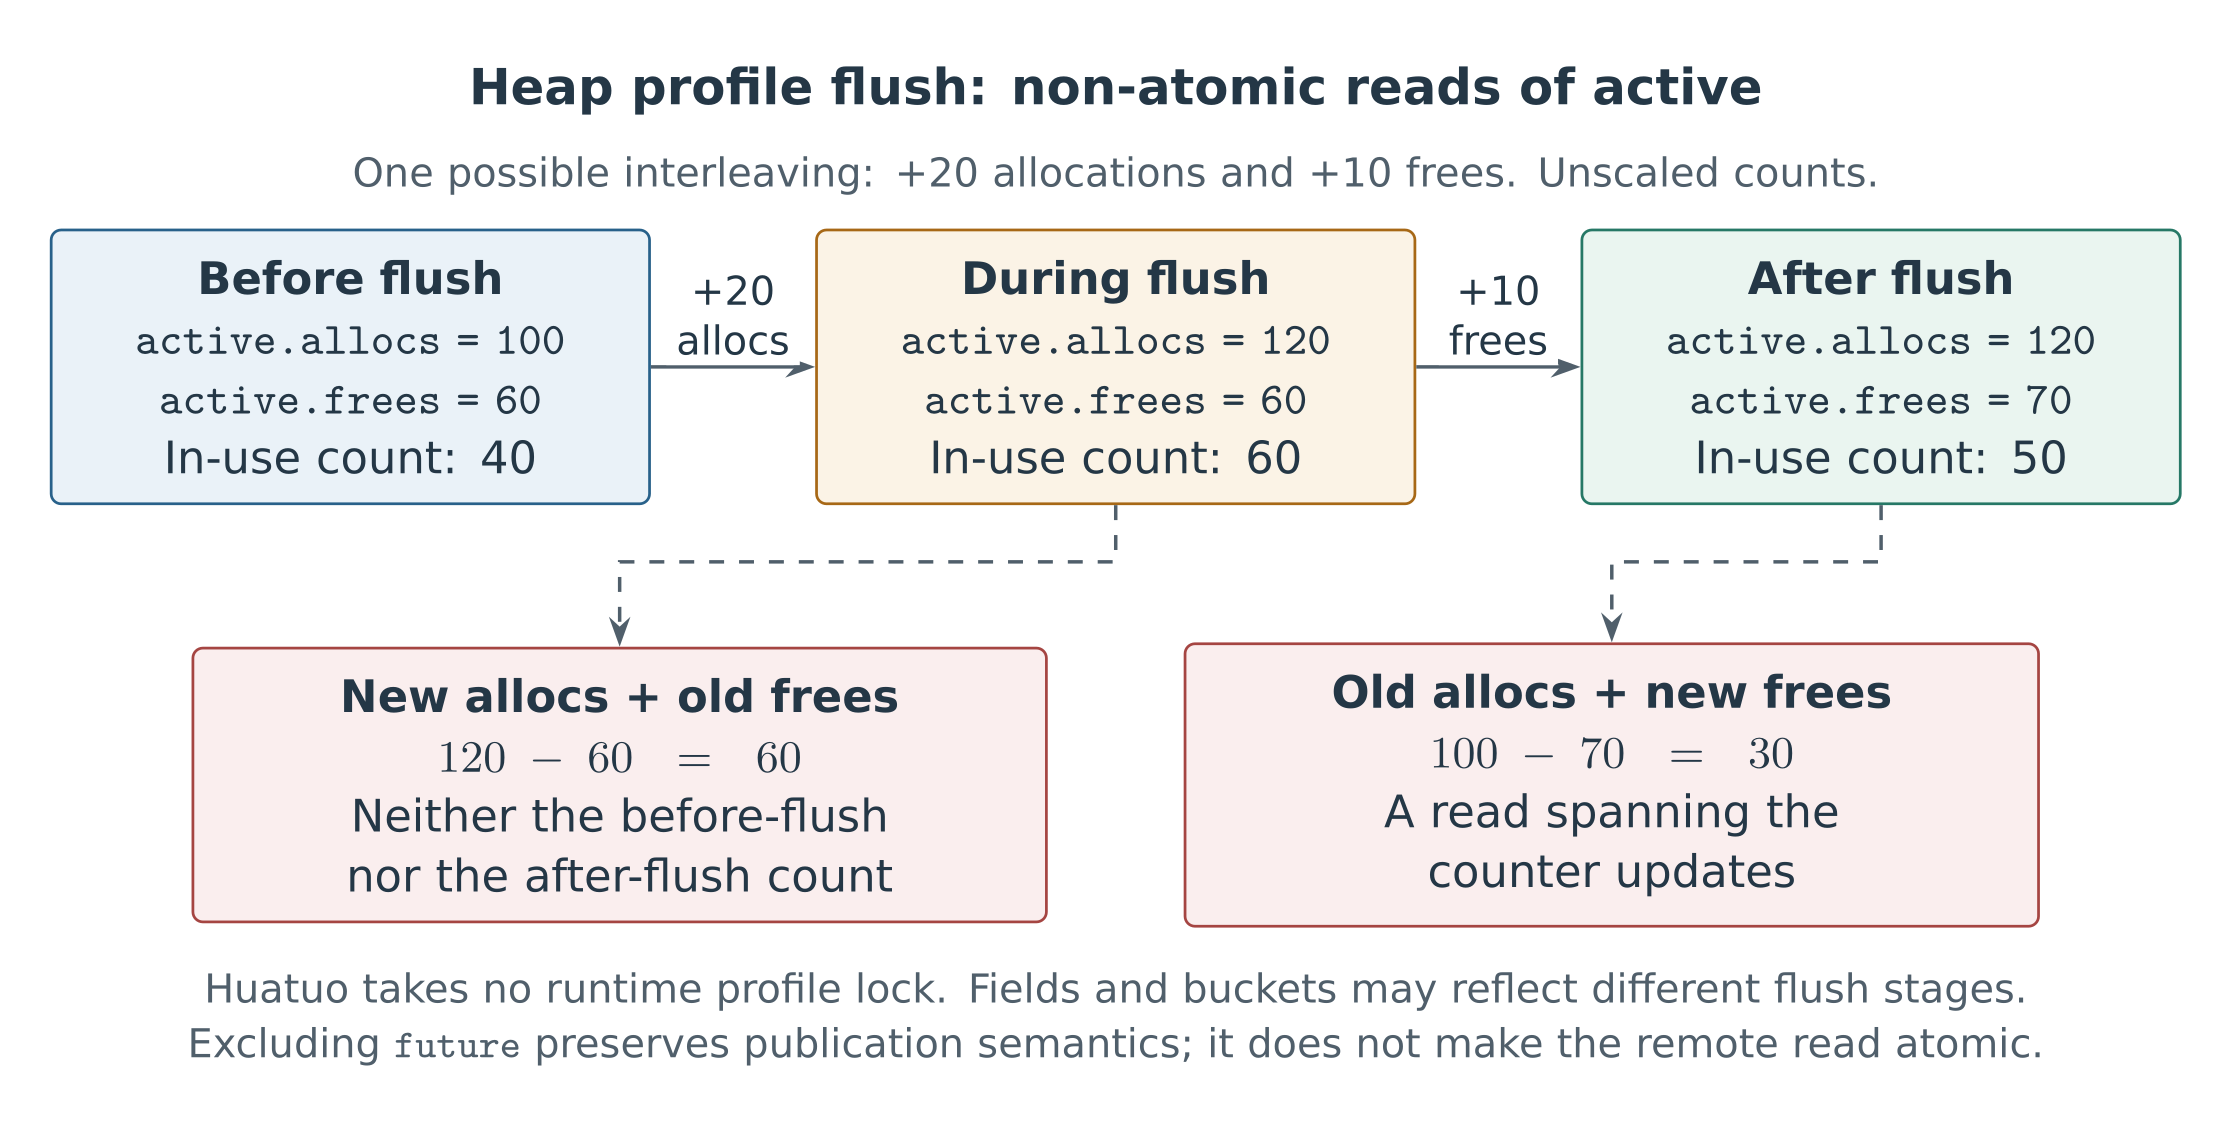
将负差值截断为零只能防止减法下溢,不能恢复一致性;跨 bucket 的发布进度也可能不同,新插入的 bucket 可能不在此次链表视图中。因此 status=complete 表示遍历完成,不代表原子快照或瞬时可达堆用量。mProf_FlushLocked
4.5 概率校正、调用栈聚合与符号化
对 active 得到的非零在用样本且 R=MemProfileRate>1 时,Huatuo 使用 pprof 的概率校正模型;R=1 不放大:
|
|
以 100 个 4 KiB 在用样本和 R=512 KiB 为例,按上述公式及整数截断规则可得约 12,850 个对象和 52,633,866 字节(50.20 MiB)。这些数值为计算示例,不构成准确度测量结果。
图 13:先按分配大小校正,再合并同栈 bucket。
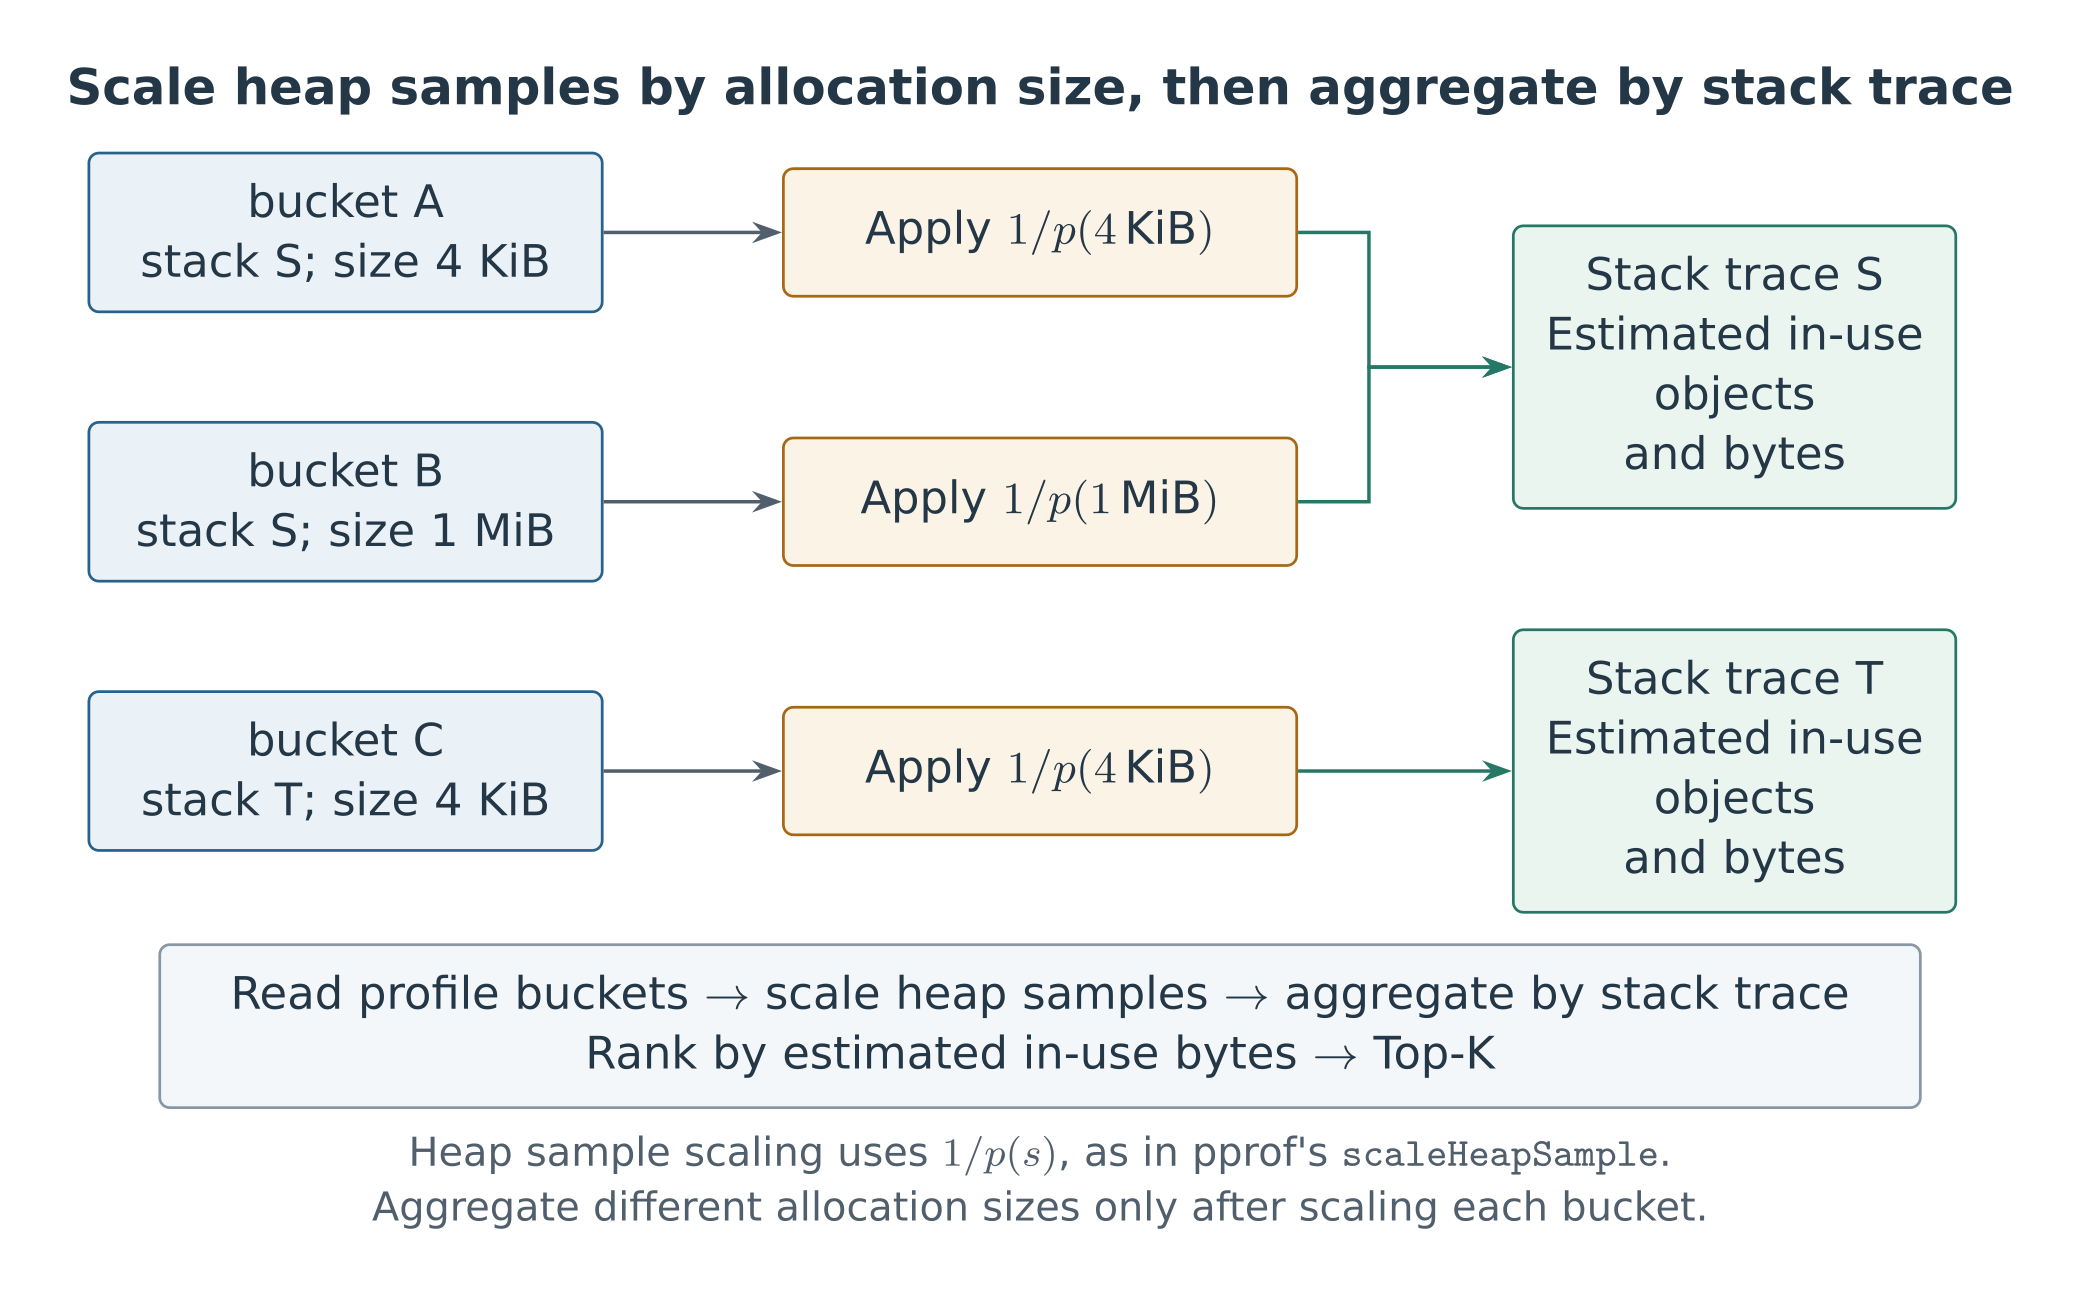
不同尺寸 bucket 的采样概率不同,先合并再校正会改变权重。因此,实现先对各 bucket 校正,再按调用栈合并,对应 aggregate.go 中的 addSample 与 scaleHeapSample。MaxMemoryObjectEntries 仅限制最终输出;扫描受预算限制时,排名只覆盖已读部分。
聚合键为原始 PC 序列,之后才符号化;name 取第一帧非 runtime 函数,stack 保存解析栈。不同 PC 栈即使函数名相同,也不一定合并,跨进程比较还需考虑 PIE 和程序版本。
4.6 输出表示与字段语义
快照使用 inuse_space_objects 表示按分配调用栈聚合的结果。以下 JSON 为结构示例,包括 duration_ms 在内的数值仅用于解释字段,不代表性能实验结果:
|
|
bytes、objects 是基于 active 差值校正后的在用估算,average_bytes 为两者相除,可能受整数截断影响,不是 Go 类型的 sizeof。输出不含逐对象地址、类型、源码行或引用关系。单个 PC 解析失败可显示十六进制地址;符号表整体构建失败则返回错误。
5. 局限性与适用范围
5.1 采样可用性与历史完整性
链接器在确认 profile 消费路径不可达且链接模式允许时,可以禁用堆采样,使运行时 MemProfileRate=0。早期版本检查 runtime.MemProfile,较新版本检查 runtime.memProfileInternal。
当前 Huatuo 在采样关闭时返回 unavailable,不会主动写入目标进程以开启采样,也无法恢复未采样的分配历史。采样率应在启动早期确定并保持稳定;中途修改后,仅凭当前值无法正确校正各时期的累计样本。MemProfileRate 约定
5.2 数值误差与归因边界
表 6:数值误差与归因范围的限制。
| 限制 | 影响 |
|---|---|
| 样本少、校正权重大 | 估算值和热点排名可能波动 |
| active 的发布时点落后于当前堆状态 | 新分配及后续释放在发布前尚未反映,估算不等于瞬时可达对象大小 |
| 缺少对象类型和引用关系 | 能定位分配栈,不能直接确认持有者 |
Go 堆之外还有其他内存,输出又是 MaxMemoryObjectEntries |
无法直接解释全部 RSS 或 cgroup 用量;但 Huatuo 项目已额外补充这些信息; |
5.3 诊断用途
图 14:快照结果的排障使用路径。
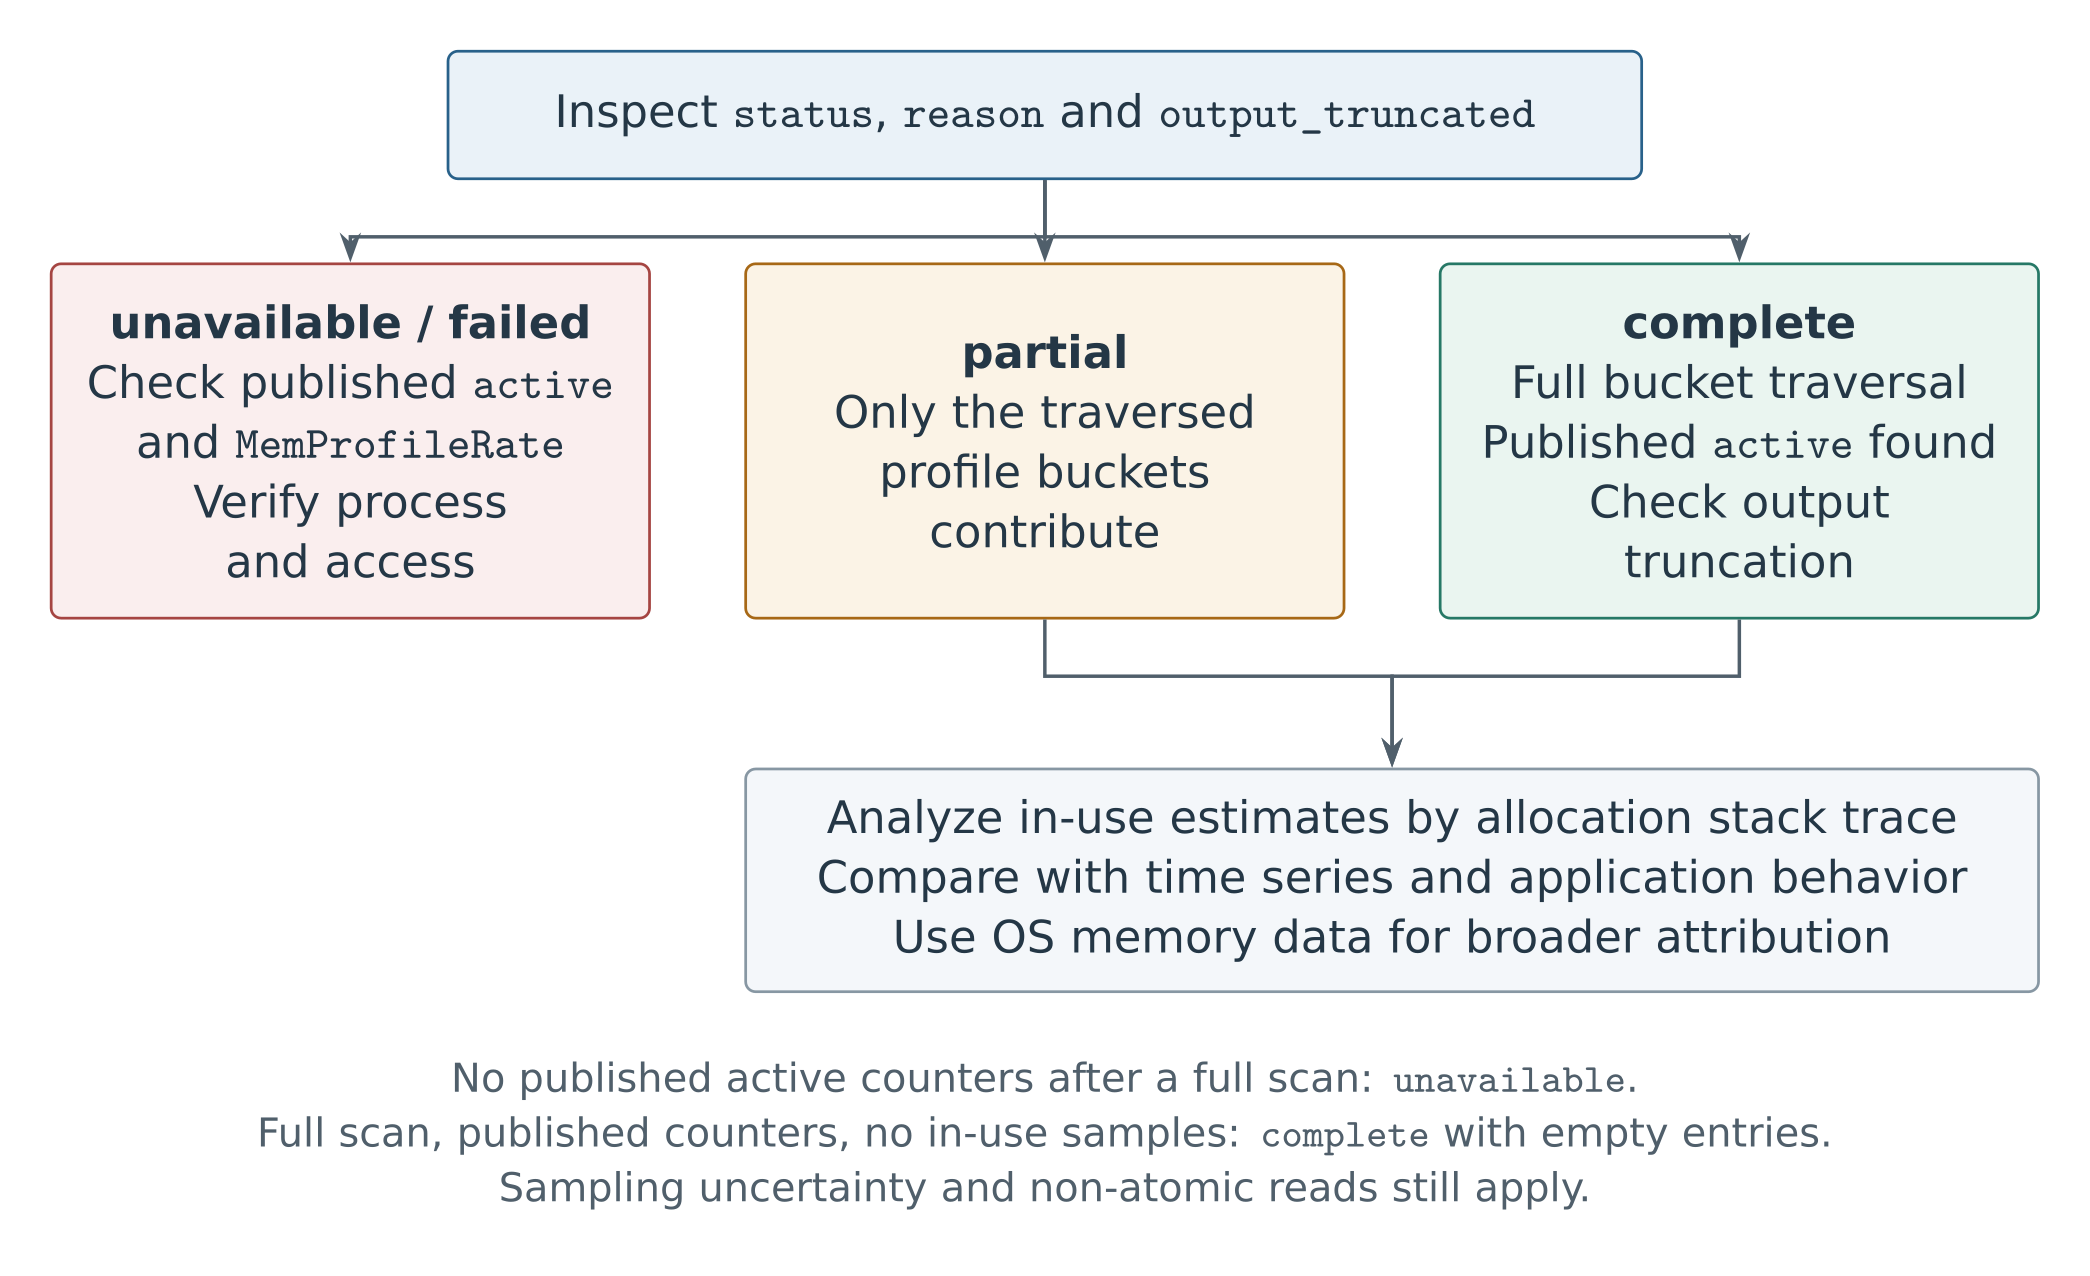
该结果可用于关联内存压力事件与分配调用链,为保留热点分析提供依据。泄漏判断、对象持有者识别以及完整 RSS 归因,仍需结合时间序列、业务行为和运行时或操作系统数据。
6. 结论
Go 运行时的堆采样统计为进程外内存归因提供了可读取的数据基础。Huatuo 通过定位 runtime 全局变量、遍历 bucket、计算 active 的在用差值、按采样概率校正并解析调用栈,将这些统计转换为事件关联的在用内存热点快照。
该方法的有效使用依赖于采样状态、运行时布局、符号定位和读取权限。其输出应解释为一次采集窗口内读取的已发布统计估计:仅使用 active 保留了 runtime 的发布延迟,因此该快照适合提供分配位置归因线索。
参考资料
| 版本标签 | runtime 堆采样源码 |
|---|---|
go1.18 |
runtime/mprof.go |
go1.19 |
runtime/mprof.go |
go1.20 |
runtime/mprof.go |
go1.21.0 |
runtime/mprof.go |
go1.22.0 |
runtime/mprof.go |
go1.23.0 |
runtime/mprof.go |
go1.24.0 |
runtime/mprof.go |
go1.25.0 |
runtime/mprof.go |
go1.26.0 |
runtime/mprof.go |
其他相关源码包括 Go 1.26 分配器、对象采样关联元数据、pprof 概率校正 和 链接器 profile 禁用判定。