
AI 根因分析的难点,已不再是模型
把监控数据交给大语言模型,它就能找出故障原因吗?要回答这个问题,得先把两件事分开:有没有把关键证据交给模型,以及模型能不能根据这些证据作出正确判断。
前一件事靠配套系统完成。它负责收集和整理数据、调用工具,并控制排查过程,即 harness。后一件事才是模型的推理能力:把看似零散的现象联系起来,分清哪些是原因,哪些是后果。
比如,一个服务拿不到足够的 CPU,所在节点的 CPU 已经满载,同节点另一个服务又占用了大量 CPU。好的模型能看出,这是另一个服务争抢资源导致的;较弱的模型可能只会列出三个异常,却说不清它们之间的关系。
因此,模型答错时,首先要弄清楚:是它没有看懂证据,还是系统根本没把证据交给它?
给模型同一份材料,看它能否找出根因
Coroot 的 AI 根因分析 会先按既定流程处理监控数据,把相关指标、事件和分析结果整理好,再交给模型。模型收到的已经是一份故障分析材料,不必自己反复调用工具、寻找线索。
这次测试也采用同样的方法:选取一个真实故障,把包含关键证据的同一份材料交给 11 个模型,每个模型测试一次,要求回答三个问题:
- 故障的根因是什么?
- 它如何一步步影响其他服务?
- 应该立即采取什么措施?
这样就能尽量排除数据收集过程的影响,重点考察模型能否在证据齐全的情况下作出正确判断。
一个容易误判的故障:网络变慢,数据库看起来也变慢了
这次故障由 Chaos Mesh 的一个 NetworkChaos 实验引起。它人为增加了 catalog 服务与 Postgres 数据库 db-main 之间的网络延迟,随后引发了一连串问题:
网络延迟增加 → catalog 等待查询结果的时间变长 → 调用它的服务也开始超时 → front-end 返回 502 错误。
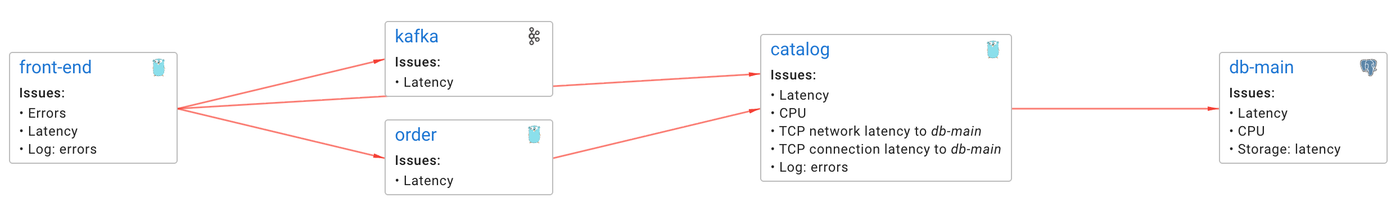
难就难在,监控中还有其他异常:kafka 延迟升高、服务 CPU 指标异常、数据库存储出现告警。一个故障往往会牵动多个指标,不能把每个异常都当作根因。
数据库指标尤其容易让人误判。网络往返时延(RTT)增加的同时,pg_stat_statements 中记录的查询耗时也在上升,看起来就像 Postgres 执行查询变慢了。但原文指出,这次多花的时间实际来自网络传输,数据库内部处理并没有变慢。
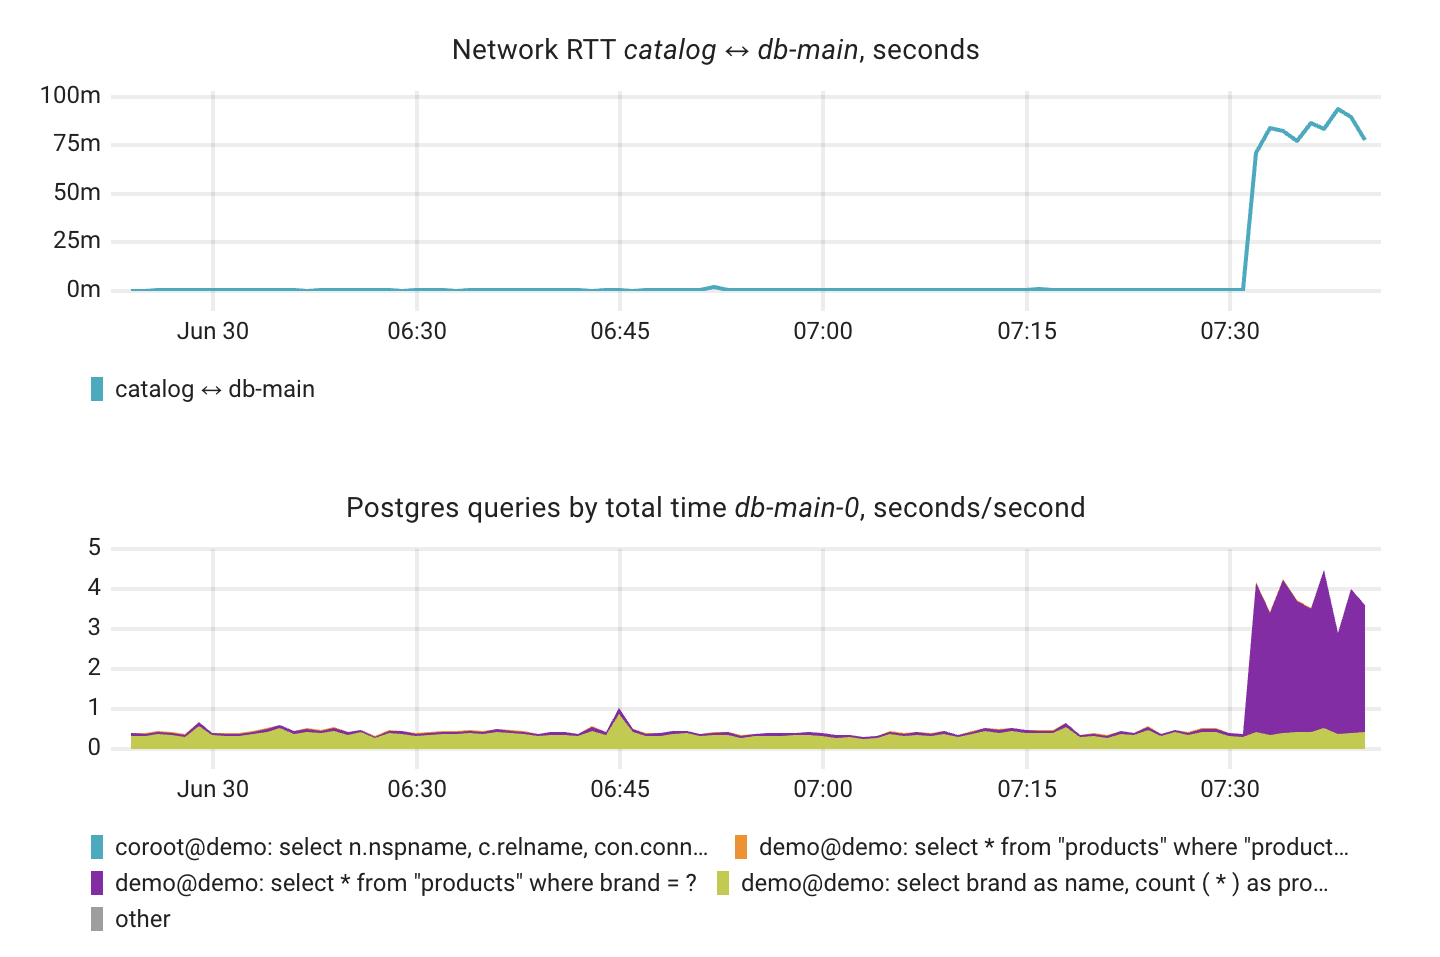
要判断问题究竟出在哪里,需要把几条线索放在一起看:
- 沿服务调用关系追查,
front-end的错误可以追溯到catalog。 catalog访问db-main时,网络往返时延、TCP 连接耗时和查询耗时一起上升。- Kubernetes 事件显示,混沌实验恰好在故障发生时启动;数据库的 CPU 性能分析则没有发现异常。
这些证据共同指向了人为注入的网络延迟。修复也要分两步:先删除正在运行的实验,让服务恢复;再删除定时启动它的调度任务,避免故障重演。
好答案要说清原因,也要把修复办法写完整
Claude Opus 4.8 给出了符合要求的答案。它从 front-end 的错误逐步追查到 catalog 的慢查询,最后定位到增加网络延迟的 NetworkChaos 实验,并用相关指标的变化支持这一判断。
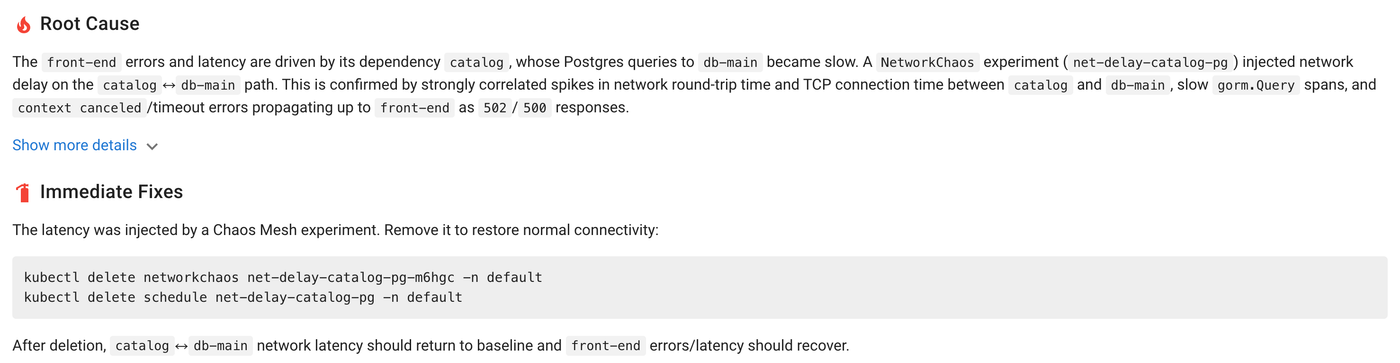
在详细分析中,它还引用了调用链中耗时较长的 gorm.Query 记录、实验启动和恢复时的 Kubernetes 事件,以及数据库 CPU 性能分析结果。修复建议也包含了删除实验和删除调度任务两个步骤。
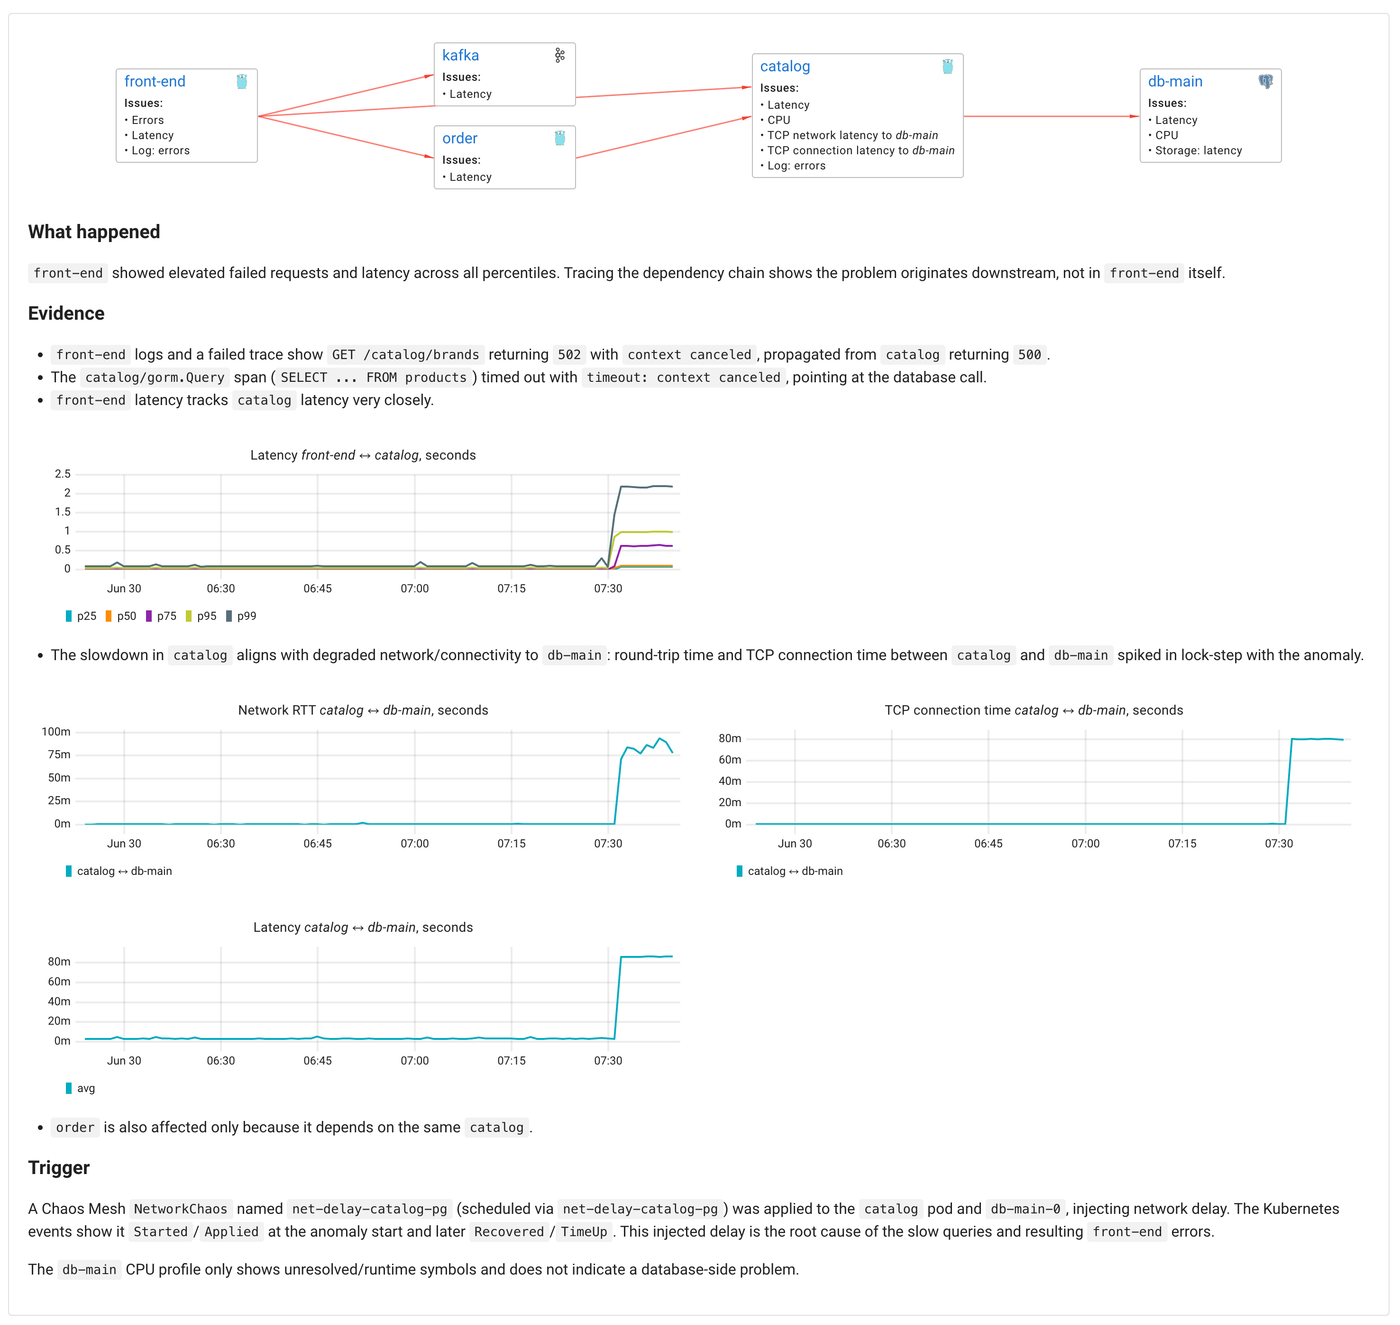
这正是测试要检验的能力:找准根因,说明故障如何影响其他服务,并给出既能恢复服务、又能防止问题再次发生的修复方案。
作者的核心观点是:只要关键证据准备充分,现有模型已经能较好地完成根因分析。随着监控数据不断增多,接下来更值得投入的工作,是在调用模型之前,把相关线索找出来、把关键证据留下来,再整理成一份简洁而完整的分析材料。